

数据库管理473期 2026-10-04
胖头鱼的技术专栏-473 改 JSON 的一个字段不再重写整篇:我给 PostgreSQL 18 写了个扩展(20261004)
作者:胖头鱼的鱼缸(尹海文)
Oracle ACE Pro: Database
PostgreSQL ACE

10年+数据库行业经验
拥有OCM 11g/12c/19c、MySQL 8.0 OCP、Exadata、CDP等认证
墨天轮MVP,ITPUB认证专家
圈内拥有“总监”称号,非著名社恐(社交恐怖分子)

全网同名:胖头鱼的鱼缸
ITPUB:yhw1809
除授权转载并标明出处外,均为“非法”抄袭
前阵子我写过一篇《胖头鱼的技术专栏-468 JSON改一个字段,凭什么要重写整篇?(20260910)》,把 MongoDB、PostgreSQL、Oracle 三家在高频 JSON 更新场景下的写放大摆在一起横评了一轮。文末我留了个"退而求其次"——卡在 PostgreSQL 上的,把高频更新的字段拆出来做 top-level column,JSONB 只存半静态属性。
那篇发完,我一直在思考:说起来轻巧,真干过的人都知道它是句正确的废话——JSON 文档里改一个字段,拆列谁不会?问题是拆完之后,应用的读写路径全得跟着改一遍,而这个改动量,恰恰是大多数团队宁可忍着 CPU 告警也不动手的原因。
所以这次我没接着写文章,而是动手把这件事做进数据库里了。本期跟随总监,看看这个刚做完的 PostgreSQL 18 扩展:PG SplitJSON(pg_splitjson)0.1.0,Apache 2.0 开源。
一、那句"退而求其次"
先把上一篇的结论摆回来,不然后面接不上。
那篇文章的核心结论是:单字段高频更新这件事,Oracle 26ai 的 JSON Relational Duality View 是当时对比的几种方案里,唯一在存储层真正消灭了整篇重写的那个——或者说,是所有具备这类"JSON 文档 ↔ 规范化关系表"映射能力的数据库里走在最前面的那一类。它的做法是不让 JSON 当物理存储单元,物理上还是规范化的关系表,JSON 只是上面的一层访问接口。
而 PostgreSQL 这边,我给的建议是结构调整:手动把 stock、price、state 这些高频字段拎出来做独立列。
这个建议没错,但它有个隐含前提——你愿意改应用。
现实里我碰到过的情况基本是这样的:
- 文档模型是产品上线时就定下来的,几百处代码在读
doc->>'state'; - 拆列意味着所有读写 SQL 重写,回归测试一轮,上线窗口排期三个月;
- 更要命的是,拆出来的列和 JSONB 里剩下的内容是两份数据,双写一致性得应用层自己保证。
于是大部分团队的真实选择是:先加机器,再调 autovacuum,实在扛不住了再排期重构。放到国产化的大环境里,这条路就更难走了——换库这件事本身不是技术问题,只改一个字段这种诉求,通常排不进替换项目的需求清单。
我就想——"把热字段拆出去"这件事,凭什么每次都要人肉做一遍?能不能让数据库自己干,对外还是一张 JSON 表?
这就是 PG SplitJSON 的由来。
二、拆列这笔账
假设有这么张表:
CREATE TABLE orders (
    id     bigint PRIMARY KEY,
    doc    jsonb NOT NULL      -- 256KB 的订单详情,其中 state 每天改几十次
);
手工拆完之后是这样:
CREATE TABLE orders (
    id     bigint PRIMARY KEY,
    state  text,               -- 拆出来了
    doc    jsonb NOT NULL      -- 剩下的冷内容
);
SQL 看着就两行,但实际要付的账有四项:
- 读路径断了——原来
SELECT doc->>'state'的地方,现在要改成SELECT state;ORM 里定义的嵌套结构也得跟着改; - 写路径要双写——改
state得同时更新列和doc里的旧值,否则两份数据不一致,这时候你已经不是在优化,是在制造 bug; - JSON 语义丢了——
doc->'state' IS NULL到底是"字段不存在"还是"字段值是 JSON null"?拆成普通列之后这个区别没了,而不少业务是依赖这个区别的; - 索引语义变了——原来建的是
jsonb_path_ops的 GIN 或者表达式索引,拆完要换 B-tree,执行计划全变。
说白了,手工拆列解决的是存储问题,制造的是接口问题。
PG SplitJSON 想做的事情就一条:把拆列这件事收进数据库内部,对外仍然是一张带 id 和 doc 的 JSON 表——应用该怎么读写还怎么读写,物理上热字段已经躺在独立列里了。
三、热字段进独立列,冷模板留个坑
扩展的核心机制一句话能说完:你声明哪些路径是热的,它把这些路径的值拆到普通列,剩下的内容封成一个冷模板,读的时候再由视图拼回完整 JSON。
底下是这么摆的:
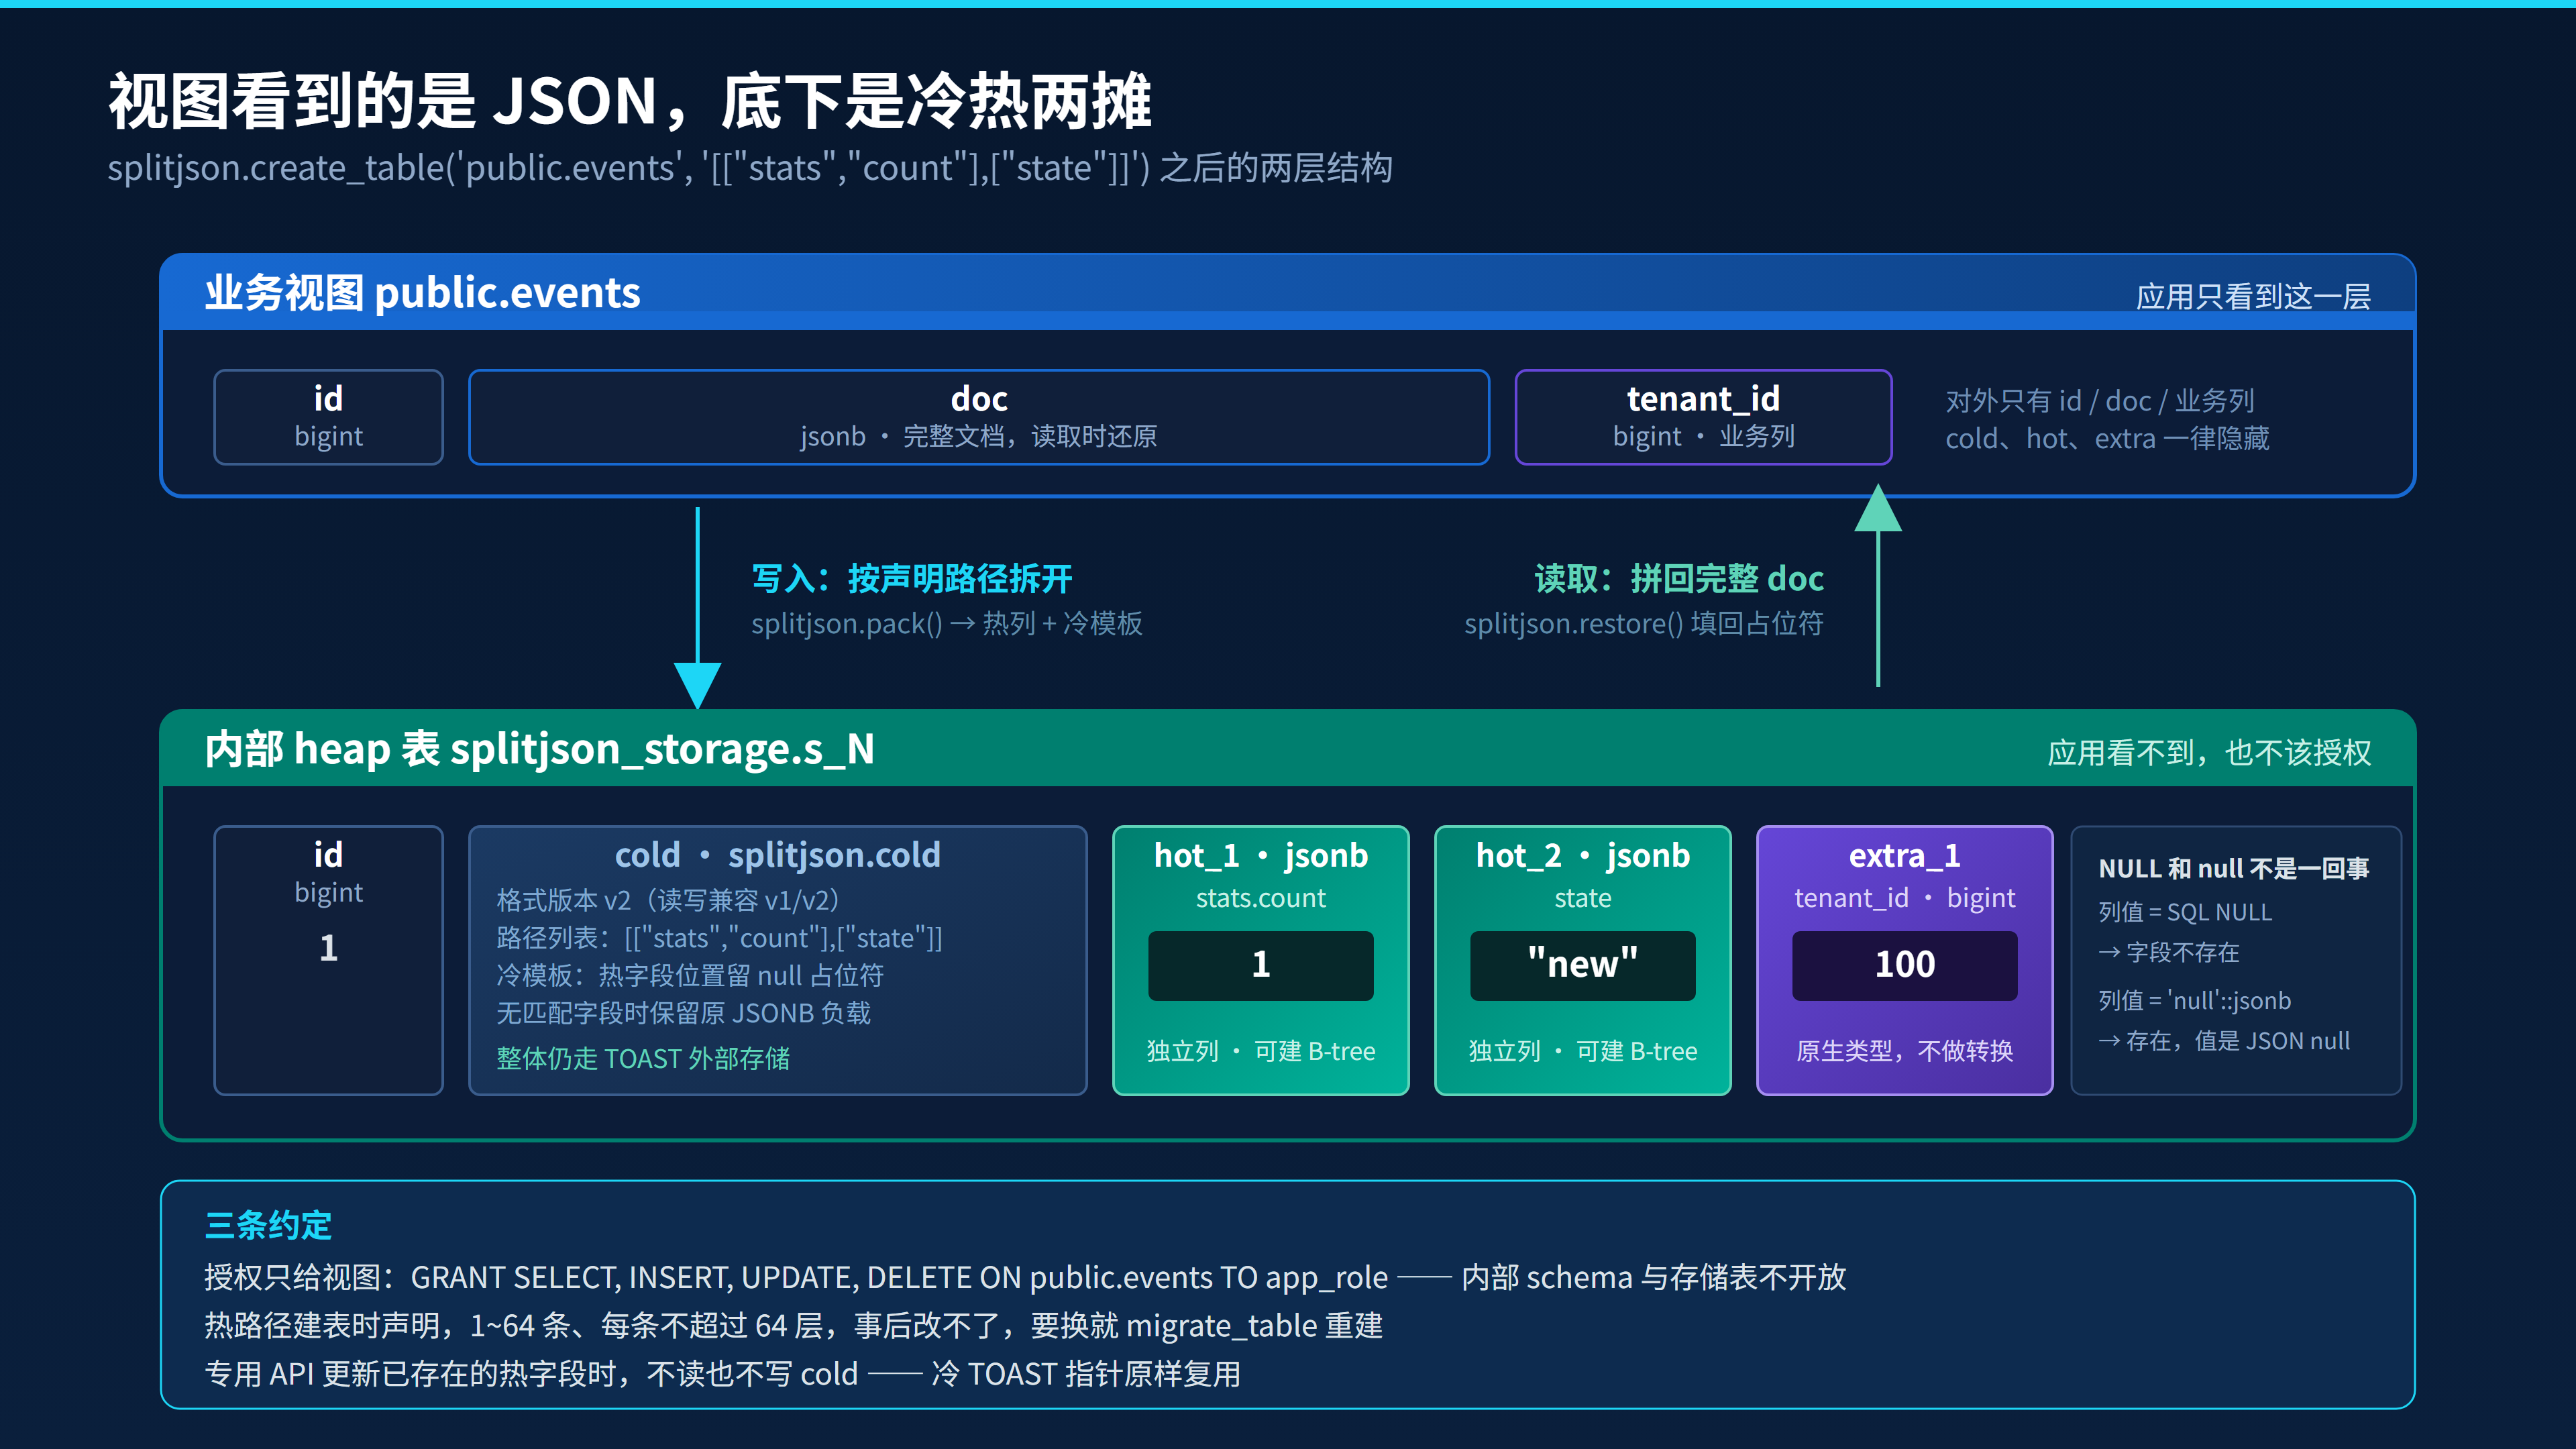
- 冷模板不是"删掉热字段后的 JSON",而是一个带版本号和路径列表的封装格式(
splitjson.cold)。热字段原来的位置留的是 null 占位符,还原时按声明路径填回去; - 占位符只在声明过的热路径上有意义——它不是一个特殊 JSON 对象,所以不会和用户数据撞车;
- 文档里没有声明的字段,不会凭空造出来。写入
{"payload":"no hot fields"}这样的文档,扩展不会给你塞一个state: null进去,原 JSONB 负载原样保留; - 热路径声明用键数组,比如
[["stats","count"],["state"]]——这是为了避免 key 里带点号时的歧义(声明stats.count到底是一个 key 还是两层?)。
热路径的下标规则也在这里定死:字符串表示对象键,非负整数表示固定数组下标。所以 ["items",0,"price"] 和 ["items","0","price"] 是两条不同的路径——前者是数组第一个元素的 price,后者是对象里 key 为 "0" 的那层。这个区别在 PostgreSQL 里本来就存在,扩展只是照着原生语义实现了。
四、安装 PG SplitJSON
编译安装走 PGXS,需要 PG18 的 server headers:
make PG_CONFIG=/path/to/pg18/bin/pg_config
make PG_CONFIG=/path/to/pg18/bin/pg_config install
然后在测试库里建表——注意这里建出来的是视图,不是表:
CREATE EXTENSION pg_splitjson;

SELECT splitjson.create_table('public.events',
    '[["stats","count"],["state"]]'::jsonb);

INSERT INTO public.events VALUES
    (1, '{"stats":{"count":1},"state":"new","payload":{"large":"cold"}}'),
    (2, '{"payload":"no hot fields"}');
更新走专用 API:
-- 已存在的热字段:只改那一列
SELECT splitjson.set_field('public.events', 1, ARRAY['stats','count'], '2'::jsonb);

-- 批量:全热字段时只产生一次物理 UPDATE
SELECT splitjson.set_fields('public.events', 1,
    '[{"path":["stats","count"],"value":3},{"path":["state"],"value":"ready"}]');

-- 计数器用这个:读和算都在行锁内完成,不会丢增量
SELECT splitjson.increment_field('public.events', 1, ARRAY['stats','count'], 0.5);

SELECT * FROM public.events;   -- 只有 id 和完整 doc,内部列看不见
这里有个细节:increment_field 不会帮你初始化缺失的计数器。字段不存在、值是 JSON null、目标不是数字,一律报 22023。
乍看有点不近人情,但这恰恰是对的——计数器丢了和计数器凭空出现,前者至少你能发现,后者可能三个月后对账才发现。
普通的 SQL DML 也照样支持,只是走不了快速路径:
UPDATE public.events SET doc = jsonb_set(doc, '{state}', '"done"') WHERE id = 1;
这条会重新拆分整个文档。所以想要性能,得用专用 API——天下没有免费的午餐,这个我在适用边界里还会再说一遍。
五、简单测试
这次最硬的一组数字在这儿。
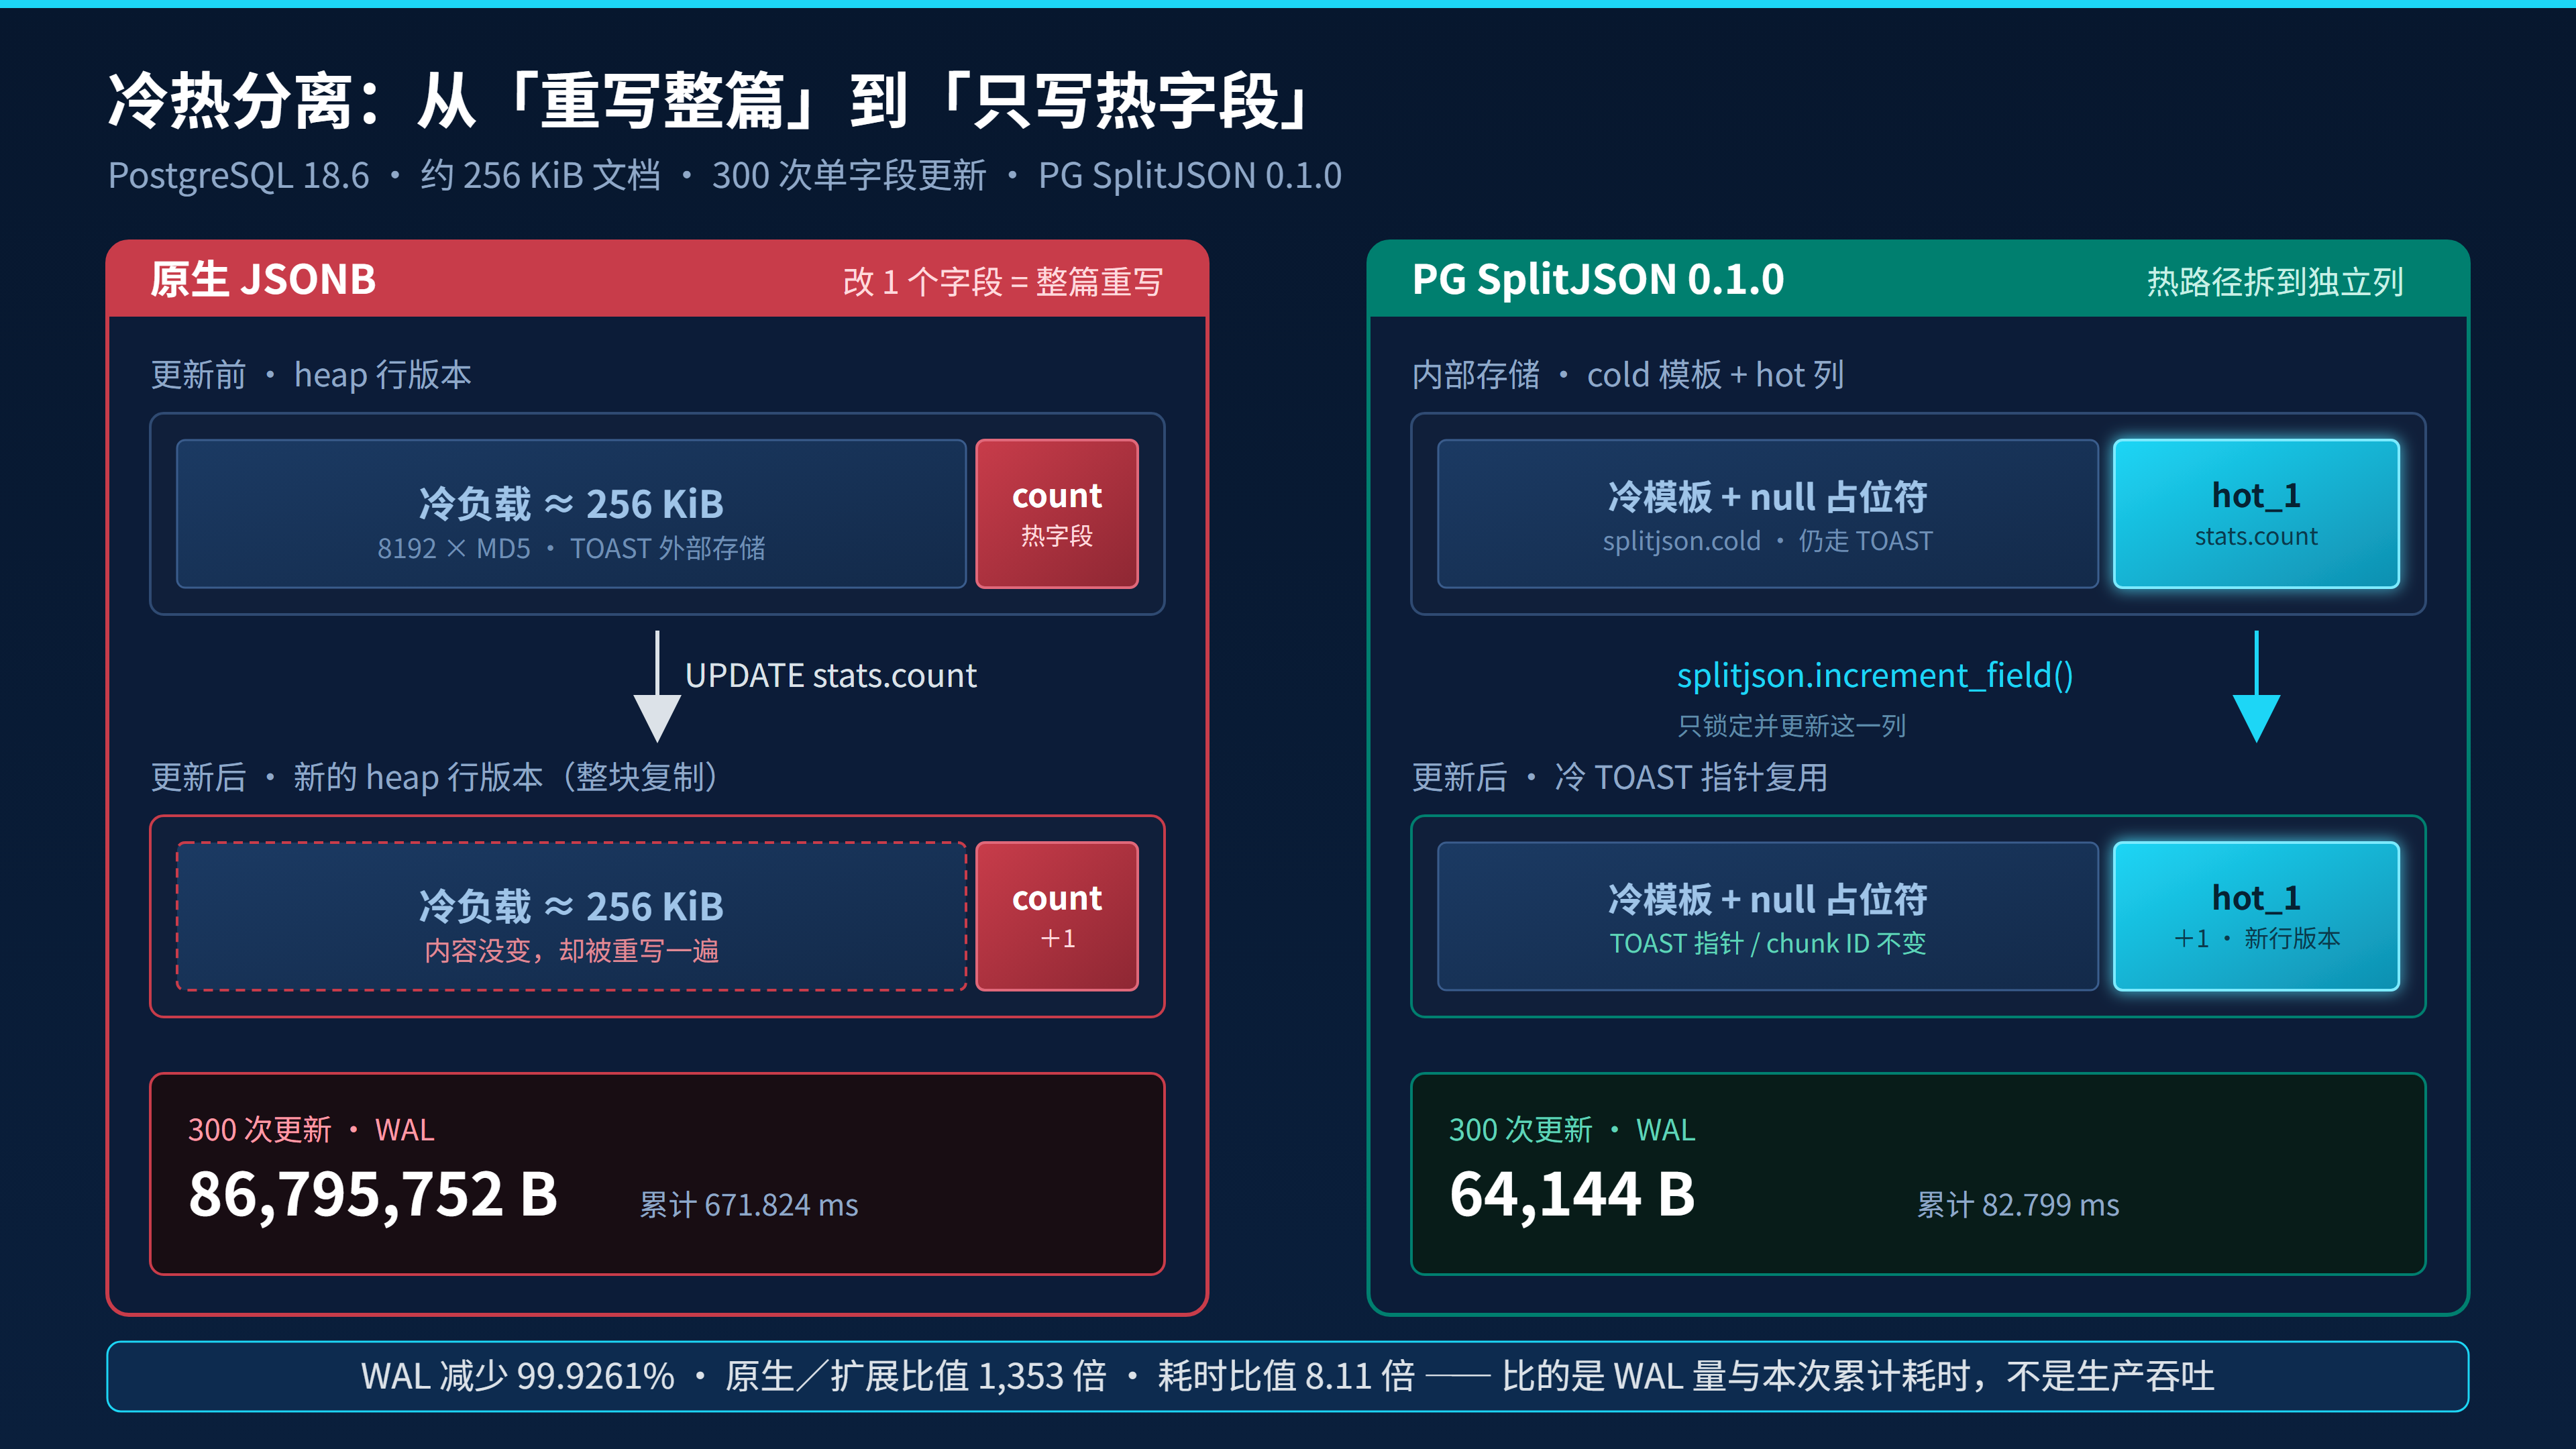
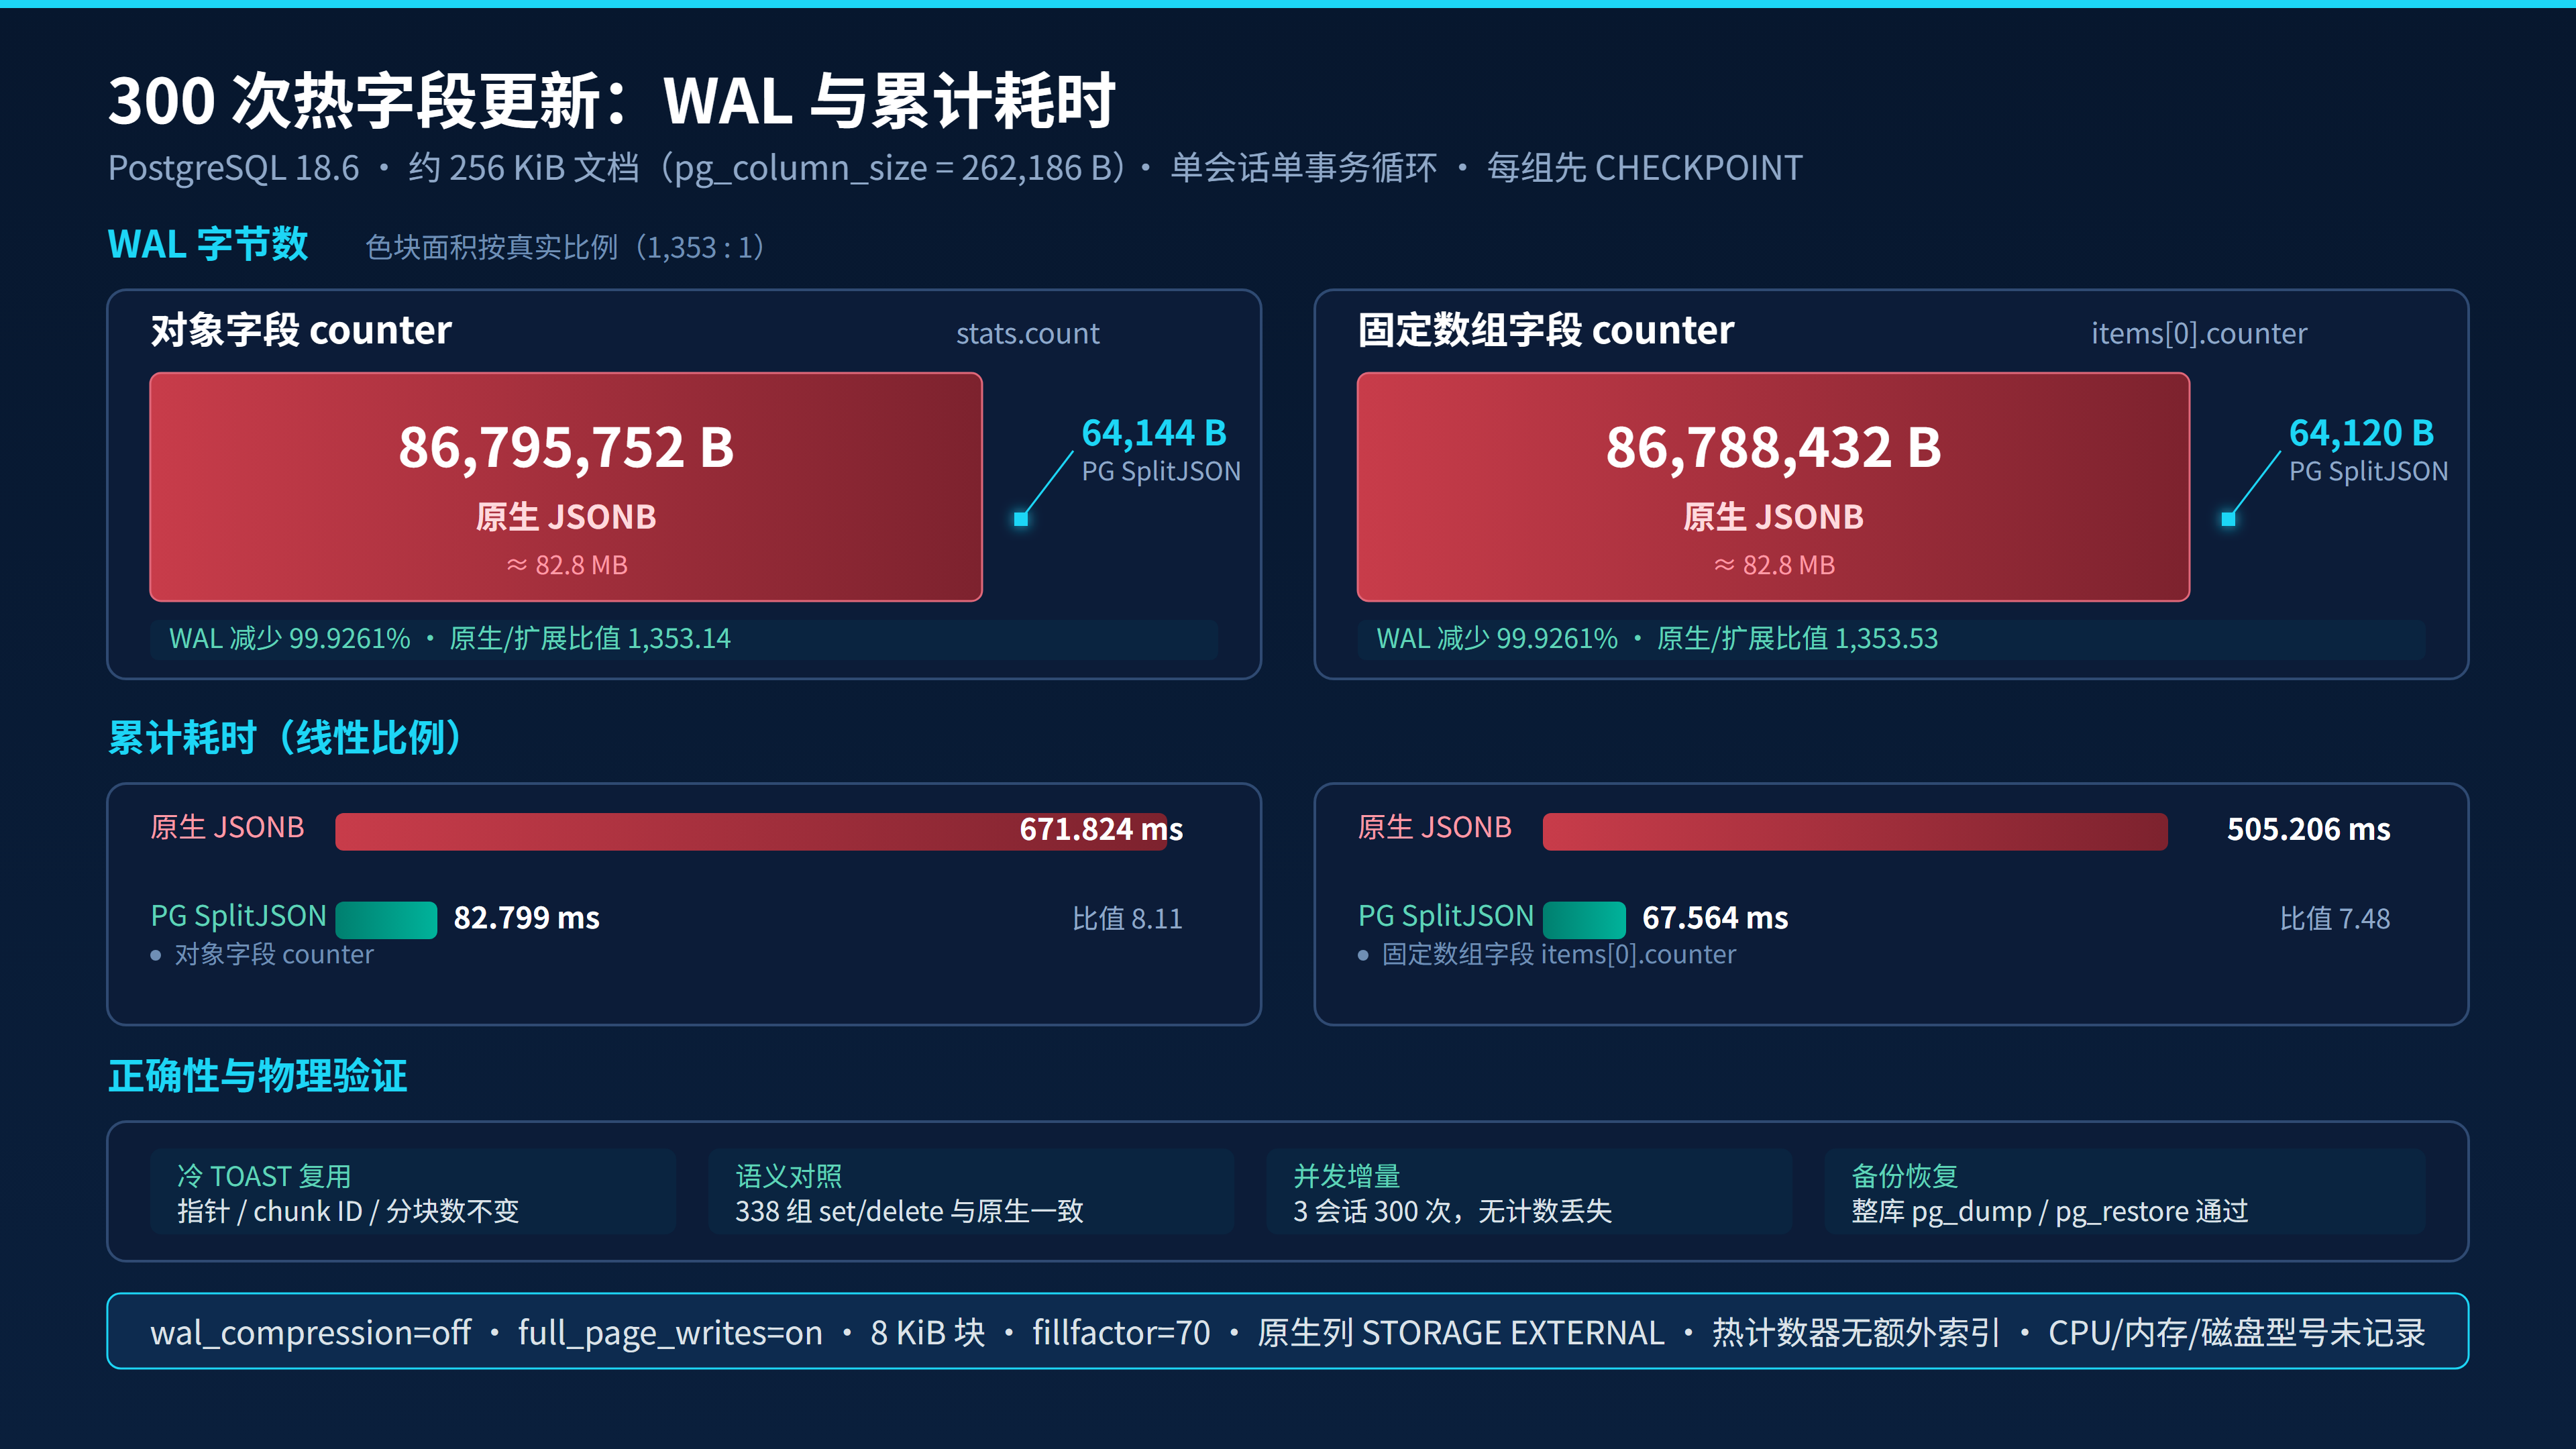
测试用一份约 256 KiB 的文档(8192 个 MD5 字符串拼出来的冷负载,pg_column_size(doc) 实测 262,186 字节),只改里面一个小小的计数器,连续更新 300 次:
| 更新场景 | 实现 | WAL 字节数 | 累计耗时 |
|---|---|---|---|
| 对象计数器 | 原生 JSONB | 86,795,752 | 671.824 ms |
| 对象计数器 | PG SplitJSON 热字段 | 64,144 | 82.799 ms |
| 数组计数器 | 原生 JSONB | 86,788,432 | 505.206 ms |
| 数组计数器 | PG SplitJSON 固定数组热字段 | 64,120 | 67.564 ms |
换算一下:
| 场景 | WAL 减少比例 | 原生/扩展 WAL 比值 | 原生/扩展耗时比值 |
|---|---|---|---|
| 对象字段 | 99.9261% | 1,353.14 | 8.11 |
| 固定数组字段 | 99.9261% | 1,353.53 | 7.48 |
也就是说:300 次更新,原生 JSONB 写了 82.8 MB 的 WAL,扩展写了 62 KB。
这个 1,353 倍的差距,本质上是"每次都把 256KB 重写一遍"和"每次只写一个计数器"的差距——文档越大、热字段越小,差距越夸张,因为它俩是同一个比值里的分子和分母。
下面是测试的条件:
- PostgreSQL 18.6,Linux x86_64,GCC 8.5.0,全新独立实验实例;
wal_compression=off、full_page_writes=on、块大小 8 KiB、表fillfactor=70;- 原生 JSONB 列用
STORAGE EXTERNAL(不压缩,这是公平对比的前提); - 每组先 CHECKPOINT,再单会话单事务循环跑完 300 次;
- 热计数器上没有额外 B-tree 索引,表只有 id 主键;
- WAL 按实例级 LSN 差测量,可能含后台 WAL;时间含少量测量语句开销。
1,353 倍比的是 WAL 的量,8.11 倍比的是这 300 次加起来的耗时,跟生产吞吐都不是一回事——它不等价于"快了 8 倍"。单条提交的开销、跑久了会不会膨胀、生产持续负载长什么样,仍然需要去探索。
六、冷文档到底动没动
光看 WAL 和时间还不够——你怎么知道扩展真的没重写冷文档,而不是偷偷重写了只是没记进 WAL?
所以我加了一组物理存储检查,用 pageinspect 直接翻 heap 里那个 18 字节的 external TOAST 指针:
- 连续热更新前后,冷文档的 TOAST 指针、chunk ID、分块数量、总字节数、内容摘要全部保持不变;
- 带索引的固定数组热更新、热数组内部批量更新、热字段删除,也都验证了冷 TOAST 复用;
- 反过来,当数组结构变化导致固定位置移位时,冷模板确实重新存储了,热值和索引同步更新。
这组检查的意义在于:前面的性能数字是"结果",这里的 TOAST 指针不变是"证据"。有了它,才能说清楚收益是从哪来的,而不是玄学。
顺带把正确性和并发的验证结果也列一下:
| 验证项 | 实测结果 |
|---|---|
| 不同形状文档回归 | 256 个文档通过 |
| 原生数组语义对照 | 338 组 set/delete,结果与 SQLSTATE 和原生 JSONB 一致 |
| 对象原子增量 | 3 个会话共 300 次增量,无计数丢失 |
| 固定数组字段增量 | 3 个会话共 150 次增量,无计数丢失 |
| 热数组子树增量 | 3 个会话共 150 次增量,无计数丢失 |
| 全热批量更新 | 审计触发器确认一次物理 UPDATE |
| 备份恢复 | 整库 pg_dump/pg_restore 后,数组、索引、权限、更新检查通过 |
七、一点额外的好处
拆出来之后还有个额外好处:热字段变成了普通列,就能建普通 B-tree 索引,查询也能走普通索引扫描。
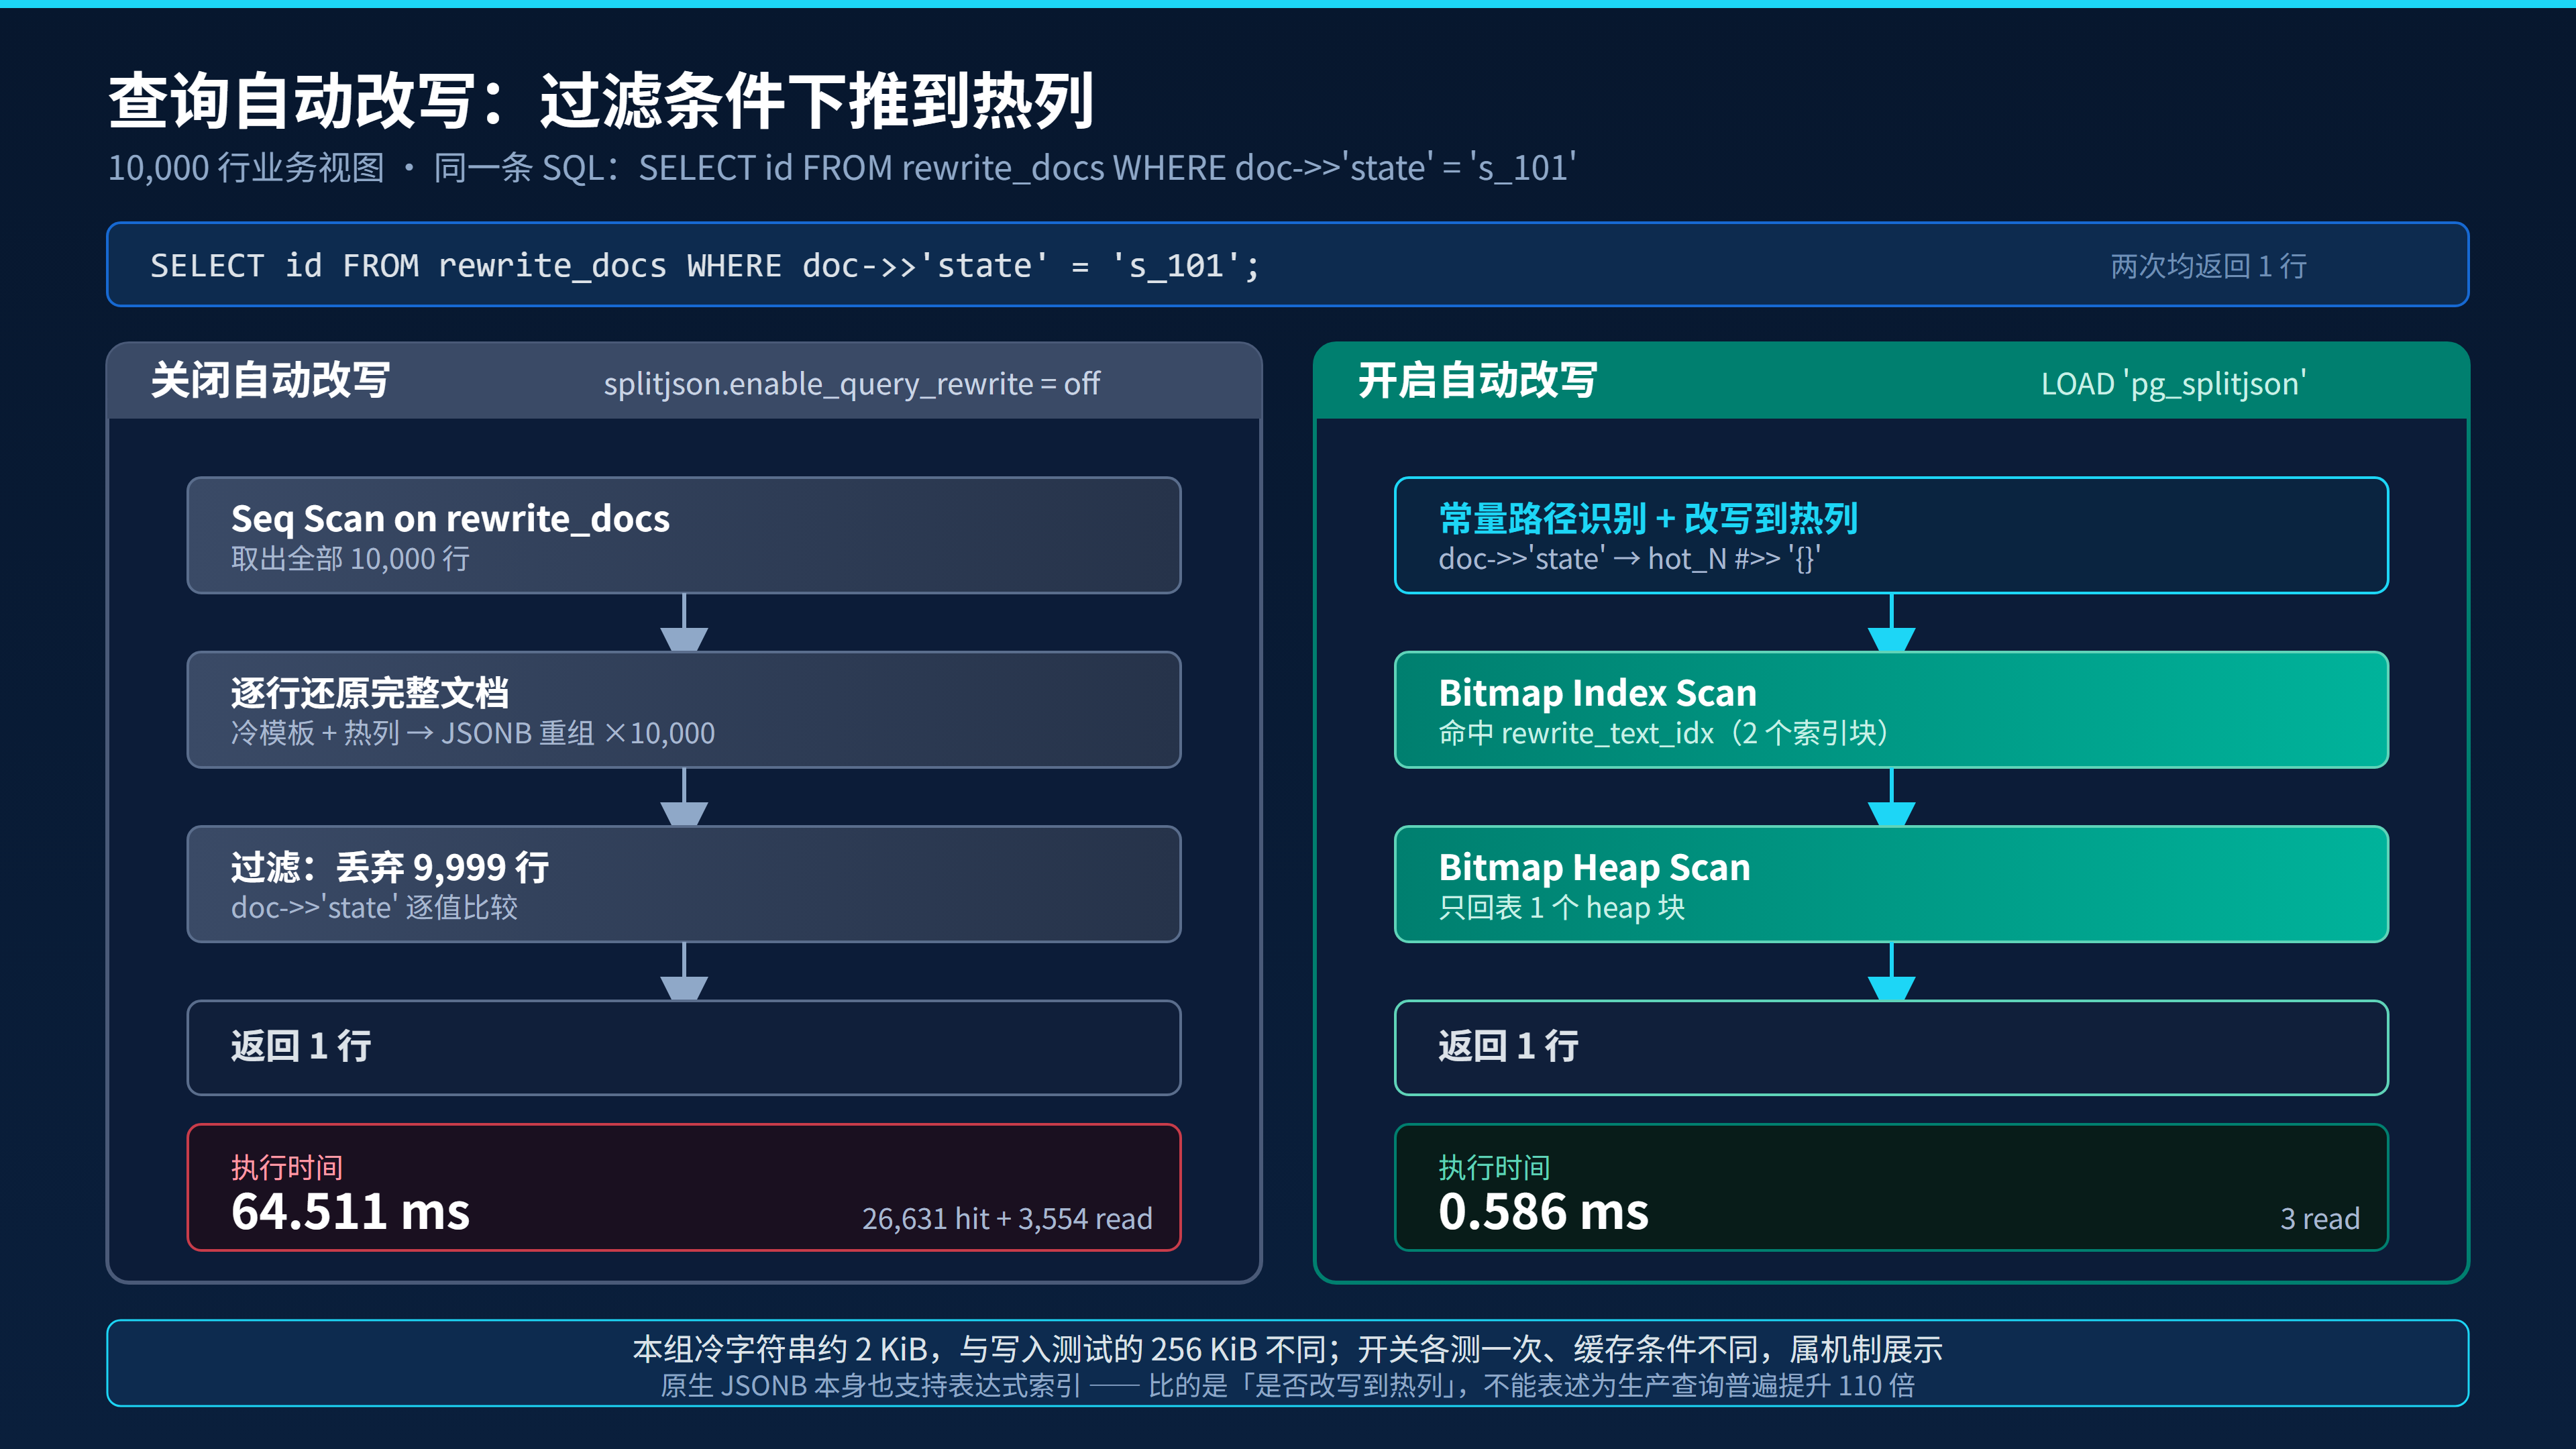
但这里有个坑——应用写的是 doc->>'state' = 's_101',它不知道 state 已经跑到独立列里了。这种情况下,PostgreSQL 默认会老老实实把 10,000 行文档全部还原出来再过滤。
所以 0.1.0 做了一个自动查询改写:在规划前加载模块,支持的常量路径提取表达式会被改写到热列上。
LOAD 'pg_splitjson';   -- 或管理员配 session_preload_libraries
SELECT splitjson.create_path_index('public.orders','orders_state_text_idx',
    ARRAY['state'],'text');
EXPLAIN SELECT id FROM public.orders WHERE doc->>'state'='new';
10,000 行视图上的对照结果:
| 自动改写 | 实际执行方式 | 执行时间 | 执行阶段 shared buffers |
|---|---|---|---|
| 关闭 | 顺序扫描、还原文档、过滤 9,999 行 | 64.511 ms | 26,631 hit + 3,554 read |
| 开启 | Bitmap Index Scan + Bitmap Heap Scan | 0.586 ms | 3 read |
开启之后,过滤条件直接打在热列上,访问两个索引块加一个 heap 块就完事了。
但这组的措辞要更保守:
- 这次的冷字符串只有约 2 KiB,不是写入测试那套 256 KiB;
- 开关各测一次,缓存条件不同,属于计划和存储访问机制的展示;
- 那 110 倍的耗时比值不能表述成"生产查询普遍快 110 倍"。原生 JSONB 自己也能建表达式索引,这里比的是"改不改写到热列",不是"能不能用索引"。
一句话总结这节:自动改写的价值是让查询命中热列索引、避免逐行重组完整文档,不是凭空变出一个新索引能力。
八、三种数组用法和一把行锁
数组是这次做得比较细的一块。三种用法,代价完全不同:
- 整个数组当热值——
["items"]声明为热路径,读写都快,但改数组内部一个元素仍然要重写整个热数组; - 固定位置下标——
["items",0,"counter"]声明为热路径,只有这一个槽独立存储,改它就只写它; - 热子树——已经拆出来的热数组内部再细改,扩展只更新对应热列。
第 2 种有个必须知道的副作用:固定数组槽代表的是位置,不是身份。你在 items 数组头部插一个元素,原来第 0 位的 counter 就变成第 1 位了——这时候位置移位会触发重新拆分,冷模板重新存储,热值和索引同步更新。
批量更新这块,set_fields 的行为:
- 1~64 个操作,全落在已存在的热路径上时,合并成一次物理 UPDATE;
- 混杂冷热、要建新字段、或者引起结构变化时,还原一次、按顺序执行、一次写回;
- 任意一步失败整批回滚。
并发方面:
- 专用 API 更新时持有行锁到事务结束,同一行不同热字段的更新仍然串行——这一点没变,别指望它解决热点行争用;
- 计数器必须用
increment_field。在应用里读出来再加一然后set_field写回去,照样丢增量; - 普通视图 UPDATE/DELETE 会在行锁内检查包括业务列在内的完整旧行,发现行变了报
40001,应用按自己的事务策略重试就行。
九、一些边界
在 0.1.0 版本,还存在一些边界:
第一,它没有绕开 MVCC。 热字段更新照样生成新的 heap tuple,照样有行版本、行锁、WAL 和 vacuum。它省掉的只是"那个 256KB 的冷值被反复重写"这一部分——省得很多,但不是零。
第二,读完整文档要重组。 每次 SELECT * 都要把冷模板和所有热列拼起来。所以这套东西适合"冷内容大、热字段小、更新频繁、但整篇读取不那么频繁"的负载。反过来,如果你每次都要读整篇文档,那是在给每个查询加 CPU。
第三,热路径不能动态改。 建表时声明,之后改不了。要换声明,得 migrate_table 重建。这条在 0.1.0 是硬限制。
第四,它不是完整的 ORM 透明层。 视图的 ON CONFLICT、RLS、分区、自动逻辑复制重组,这些 0.1.0 都没提供。另外 pg_dump -t 只导业务视图是不完整的,备份要整库 pg_dump -Fc(这条已经实测通过了)。
还有几项没测:单条提交的成本、长期膨胀、大尺寸热值、生产持续负载。上面这些数字适合说明"大冷文档、小热字段、高频更新"这个场景的机制和收益,别直接拿去做容量规划。
十、能用么?
给张速查表收个尾:
| 你的情况 | 建议 |
|---|---|
| 文档几十 KB 以上,冷内容长期不变,少数字段高频改 | 值得试,收益最大 |
| 文档几 KB,更新频率一般 | 别折腾,原生 JSONB 够了 |
| 每次查询都要读完整文档,更新反而不多 | 不合适,重组开销会吃掉收益 |
| 数组结构经常增删元素 | 谨慎,固定槽移位会触发重新拆分 |
| 热点行的并发争用才是瓶颈 | 不合适,行锁没变 |
| 需要 RLS / 分区 / 视图级 UPSERT | 等后续版本 |
| 已经在用 Oracle 26ai(或有同类能力的数据库) | 优先用数据库自带的那套方案,内核级的毕竟是内核级的 |
和上一篇文章的立场是一致的——这个扩展是在 PostgreSQL 上逼近"JSON 文档 ↔ 关系存储"效果的一次工程尝试,不是替代品。Duality View 那一类方案是把 JSON 从物理存储层降级为访问层,这个扩展是在 PostgreSQL 的 heap + MVCC 之上做冷热分离,思路同源,落点不同:一个改存储模型,一个改存储布局。有现成的内核级能力时,没必要自己在外面糊一层。
总结
回到开头那个别扭劲儿。
上一篇文章我给出的建议是"把高频字段拆出来"——这个建议本身没错,错在我默认了"拆列的成本由应用承担"是件理所当然的事。
PG SplitJSON 做的事情,说白了就是把这个成本从应用层挪回数据库层:你声明哪些路径是热的,剩下的活它自己干,对外还是那张 id + doc 的 JSON 表。
本期实测的数字说明的是缩小存储更新单元到底能省多少,实际效果取决于你的文档大小、热字段大小和更新模式——0.1.0 是初始实现,先在测试环境跑,别直接上生产。
项目地址:https://github.com/Haiwen-Yin/pg_splitjson ,Apache 2.0,PG18 可编译,欢迎提 issue。
众所周知,写文章是给人看的,写代码是给自己挖坑的——这次两件事一起干了。
老规矩,知道写了些啥。