

10 月 3 日 Google 把 Spanner Queues 推向 GA。这是第一个由头部云厂商以"原生数据库对象"形态落地的消息队列(不是 sidecar、不是外挂),用一套 DDL 就能定义队列、入队消费全在事务里。本文拆解它的五大机制、与 MongoDB Atlas Agent Engine / Databricks Lakebase / Oracle Fusion Claw 的对比,以及对国产 agent 数据库的工程借鉴。
一、为什么需要"数据库原生队列"
AI agent 的状态通常住在事务数据库里,调度却走外部消息中间件。两边提交点脱钩,会出现两类经典故障:
- 状态写入成功,调度失败:agent 决定执行但什么都没发生
- 调度成功,状态事务回滚:agent 在不存在的状态上行动
传统解法是 transactional outbox + relay + reconciliation。Google 自己把这个组合称作"可靠性税——你需要永远自己运维的基础设施"。
Spanner Queues 想做的事:把队列做成数据库对象,让"决定"和"入队"在同一个事务里原子完成,要么都成功要么都不发生。
二、Spanner Queues 的五大机制
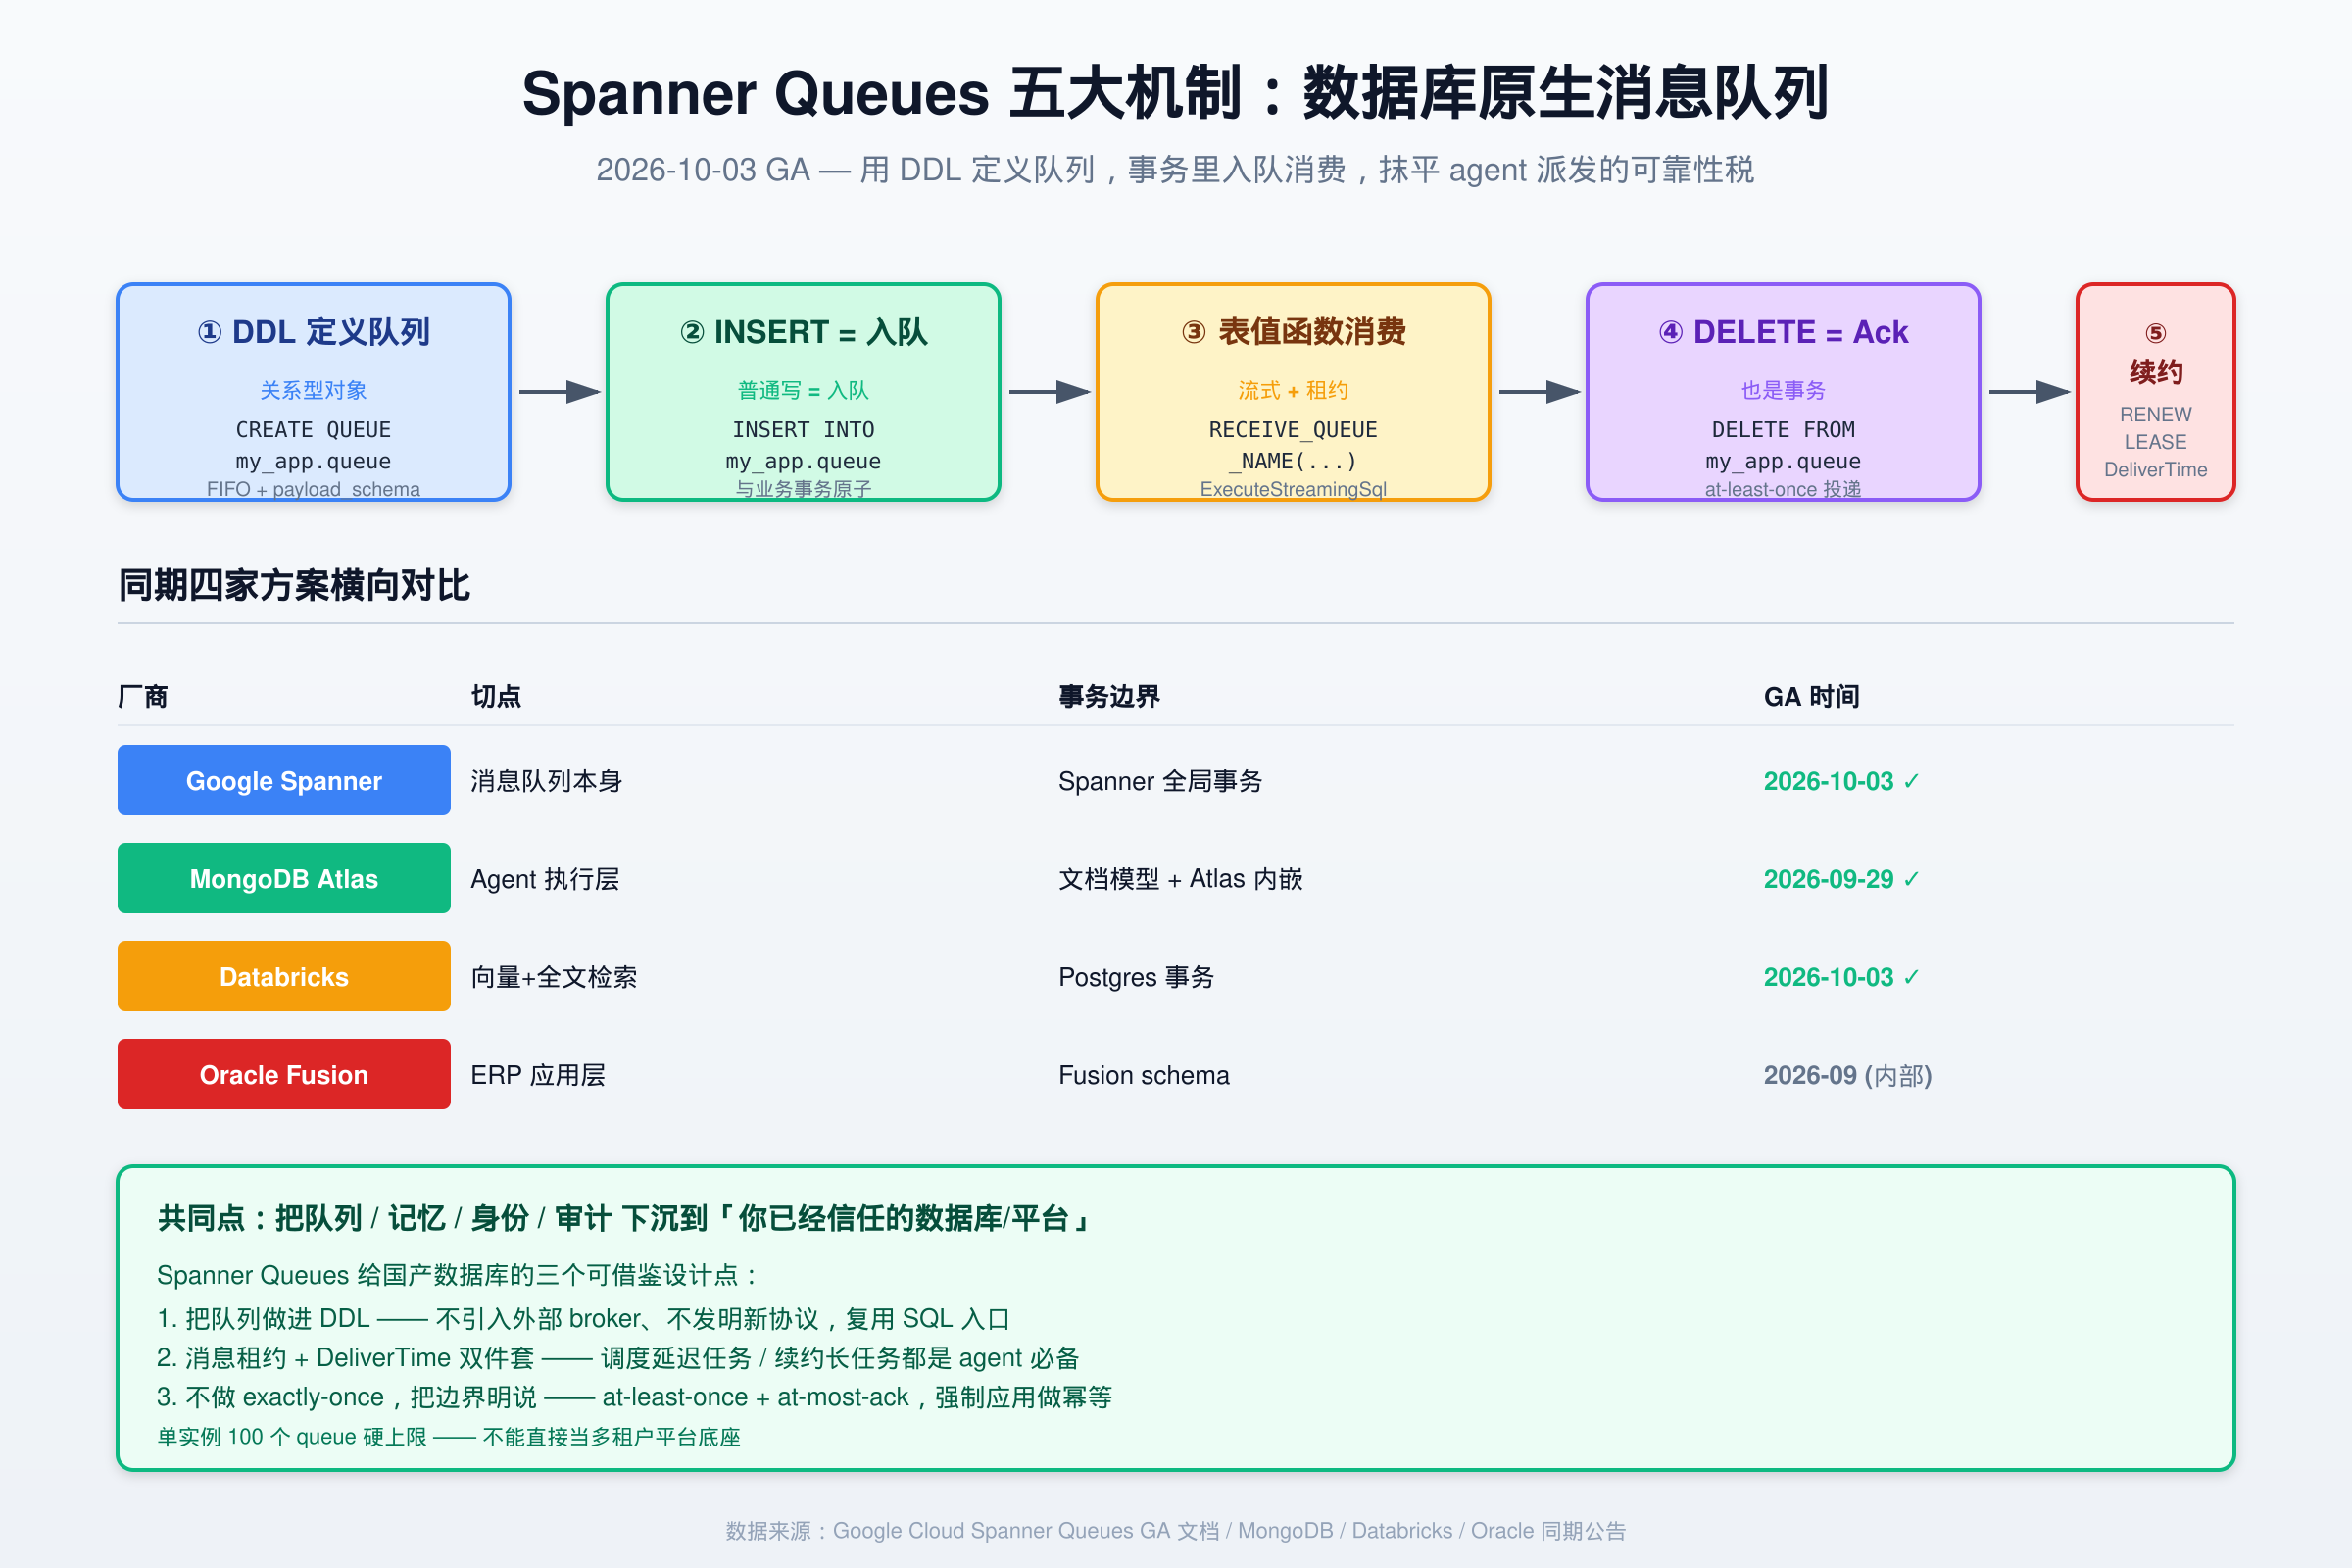
2.1 DDL 定义关系型队列
队列不是 sidecar 服务,是和表一样的关系结构:
CREATE QUEUE my_app.queue WITH
  payload_schema = SCHEMA '...'
  delivery_model = FIFO;
队列有 payload 列、主键,由 DDL 管理。本质上它就是一张特殊的表。
2.2 入队 = 一次普通写
不需要单独的 SDK、不需要外部 broker。直接 INSERT 到队列:
INSERT INTO my_app.queue (payload)
VALUES (JSON '{"agent_id":"agent-007","action":"refund"}');
INSERT 跑在读-写事务里,跟业务状态变更共用一个事务。这就是"原子决策+入队"的关键。
2.3 消费 = 表值函数
SELECT * FROM RECEIVE_QUEUE_NAME(
  'my_app.queue',
  -- 过滤参数
)
这个表值函数在读-写事务里被流式调用(ExecuteStreamingSql)。消息被 lease 锁住直到 ack 或过期。
2.4 Ack = 删除也是事务
DELETE FROM my_app.queue WHERE id = ?;
删除动作跑在事务里。如果 worker 崩溃,lease 过期后另一个 worker 会重新拿到这条消息——即 at-least-once 投递。
2.5 三个扩展能力
DeliverTime列:调度投递时间,用于延迟重试、agent 检查点、SLA 计时器RENEWLEASE_QUEUE_NAME():worker 在处理长任务时续约租约- 人在环路超时:用一个事务记录待审批 + 调度升级时间
三、Google 自己划出的边界
GA 不等于 exactly-once。官方文档明确写出几个限制,应用必须知道:
- 投递语义是 at-least-once、ack 是 at-most-once
- 应用必须安全可重试,对外部 API 传任务 ID 作幂等键
- 竞态:worker 卡住 → 租约过期 → 别的 worker 抢到 → 第一个 worker 的
ASSERT_ROWS_MODIFIED 1会失败(如果应用捕获到失败并中止) - 单实例最多 100 个 queue;同参数 active receive query 最多 1000 个
- 队列 ≠ change streams(队列是有租约的事务工作,change streams 是连续捕获用于复制)
把这套限制摆出来:它是"数据库风格的队列",不是"队列厂商的数据库"。开发者仍要自己处理幂等和并发。
四、与同期三家方案的横向对比
过去一周,把 agent 基础设施下沉到数据栈的不只 Google:
- MongoDB Atlas Agent Engine(Sep 29)——把执行、记忆、治理做成 Atlas 内置层。Runtime / Memory 走 consumption 定价,复用既有 Atlas commitment。
- Databricks Lakebase(Oct 3 GA)——在 Postgres 16+ 里加
lakebase_vector+lakebase_text,让 agent 在事务库里做向量+全文+混合检索。 - Oracle Fusion Claw(9 月内)——在 Fusion Applications 里直接内嵌 agent runtime,把执行 runtime 烤进 ERP,配套 Outcome Trust Harness 给每次运行做不可篡改 receipt。
共同点:都把队列、记忆、身份、审计这四件套下沉到"你已经信任的数据库/平台"。区别在于切点——
| 厂商 | 切点 | 走的事务边界 |
|---|---|---|
| Google Spanner | 消息队列本身 | Spanner 全局事务 |
| MongoDB | Agent 执行层 | 文档模型 + Atlas 内嵌 |
| Databricks | 向量+全文检索 | Postgres 事务 |
| Oracle | ERP 应用层 | Fusion schema |
四家没有谁覆盖谁,但合并起来就是 agent 平台的"事实底座"正在被四家瓜分。
五、对国产数据库的工程借鉴
国产数据库(OceanBase / PolarDB / TiDB / openGauss)要建 agent 平台基础设施,Spanner Queues 给出了三个可借鉴的设计点:
- 把队列做进 DDL:不引入外部 broker、不发明新协议,复用 SQL 入口。OceanBase 的"一体化"路线天然合适做这件事——事务 / HTAP / 队列在同一个内核里。
- 消息租约 + DeliverTime 双件套:调度延迟任务、续约长任务都是 agent 必备能力。国产库可以在兼容 MySQL/PG 协议的前提下加这两个字段。
- 不做 exactly-once,把边界明说:Spanner 自己只承诺 at-least-once + at-most-ack,强制应用做幂等。这个克制比"宣称 exactly-once"更工程化——agent 应用的幂等本来就该自己负责。
另一点值得国产团队注意的是单实例 100 个 queue 的硬上限。对一个 agent 平台型产品来说,这个上限意味着不能直接拿 Spanner Queues 当多租户平台底座——需要自己分层或换路径。
六、给技术人的结论
Spanner Queues GA 不是一个独立的"消息队列产品",它更像一种新原语:用 SQL 表达队列、用事务保证一致性、用 lease 表达抢占。这套原语会逐步扩散到其他云厂商的托管数据库,也会给独立消息中间件(Kafka / Pulsar / RabbitMQ)施压——它们必须回答"为什么 agent 应用应该走你的 broker,而不是在数据库里解决"。
国产数据库现在最大的机会窗口,是把这件事和 HTAP / 多模 / 向量检索绑在一起讲——同一个内核支持事务、分析、消息、向量检索,而不是再外挂一层。当 2026 下半年的 agent 基础设施竞赛进入第二阶段,"原生"会变成默认要求。
延伸阅读
- https://n8nlab.io/news/google-spanner-queues-agent-messaging
- https://www.mongodb.com/company/newsroom/press-releases/mongodb-launches-atlas-agent-engine-to-put-ai-agents-in-production-without-a-new-stack
- https://www.thenextgentechinsider.com/pulse/databricks-launches-lakebase-search-for-postgres-with-integrated-vector-and-text-capabilities
- https://forkast.news/oracle-fusion-claw-brings-native-ai-agent-orchestration-to-the-erp-layer/
- https://www.dbta.com/Editorial/News-Flashes/Amazon-Aurora-PostgreSQL-Now-Delivers-Direct-Querying-of-Apache-Iceberg-and-Parquet-Data-in-the-Data-Lake-176838.aspx