

Google 把自家最具差异化能力的 Spanner 主动搬出 Google Cloud、允许跑在 AWS 与笔记本上,这事本身就值得停下来看架构图。2026 年 10 月 Spanner Omni 正式 GA,引擎本体没有变,但两条支撑假设被替换:Colossus 分布式文件系统 → 本地盘挂抽象,TrueTime 原子钟+GPS → 软件时钟。本文拆 Omni 的部署形态矩阵、两条替换路径、被显式排除的集成项,以及给国产分布式数据库的可借鉴工程信号。
一、Omni 是什么,为什么这次不是简单的"私有化"
Spanner 是 Google Cloud 上的全球分布式强一致 SQL,长期卖点是"无需手工分片、无需选主、自动扩容到全球"。过去这条能力只能通过 Google Cloud 上的托管服务消费,客户如果想搬到自己机房,Google 不会卖。Spanner Omni 把这套引擎重新打包成"可下载的软件",覆盖以下四类环境:
- Google Cloud 内的自管部署(可以保留 BigQuery 集成路径)
- Amazon EC2 / EKS 上的自管部署
- 本地数据中心(VM、Linux 容器、K8s)
- 笔记本与边缘(Developer Edition)
与传统的"卖 license + 跑在客户机房"私有化不一样的是,Omni 同一份二进制要在 4 类环境里都跑得起来,且都要维持强一致。这就要求引擎本身剥离掉两条 Google 内部才有的支撑假设——下文重点拆这两条。
二、部署形态矩阵
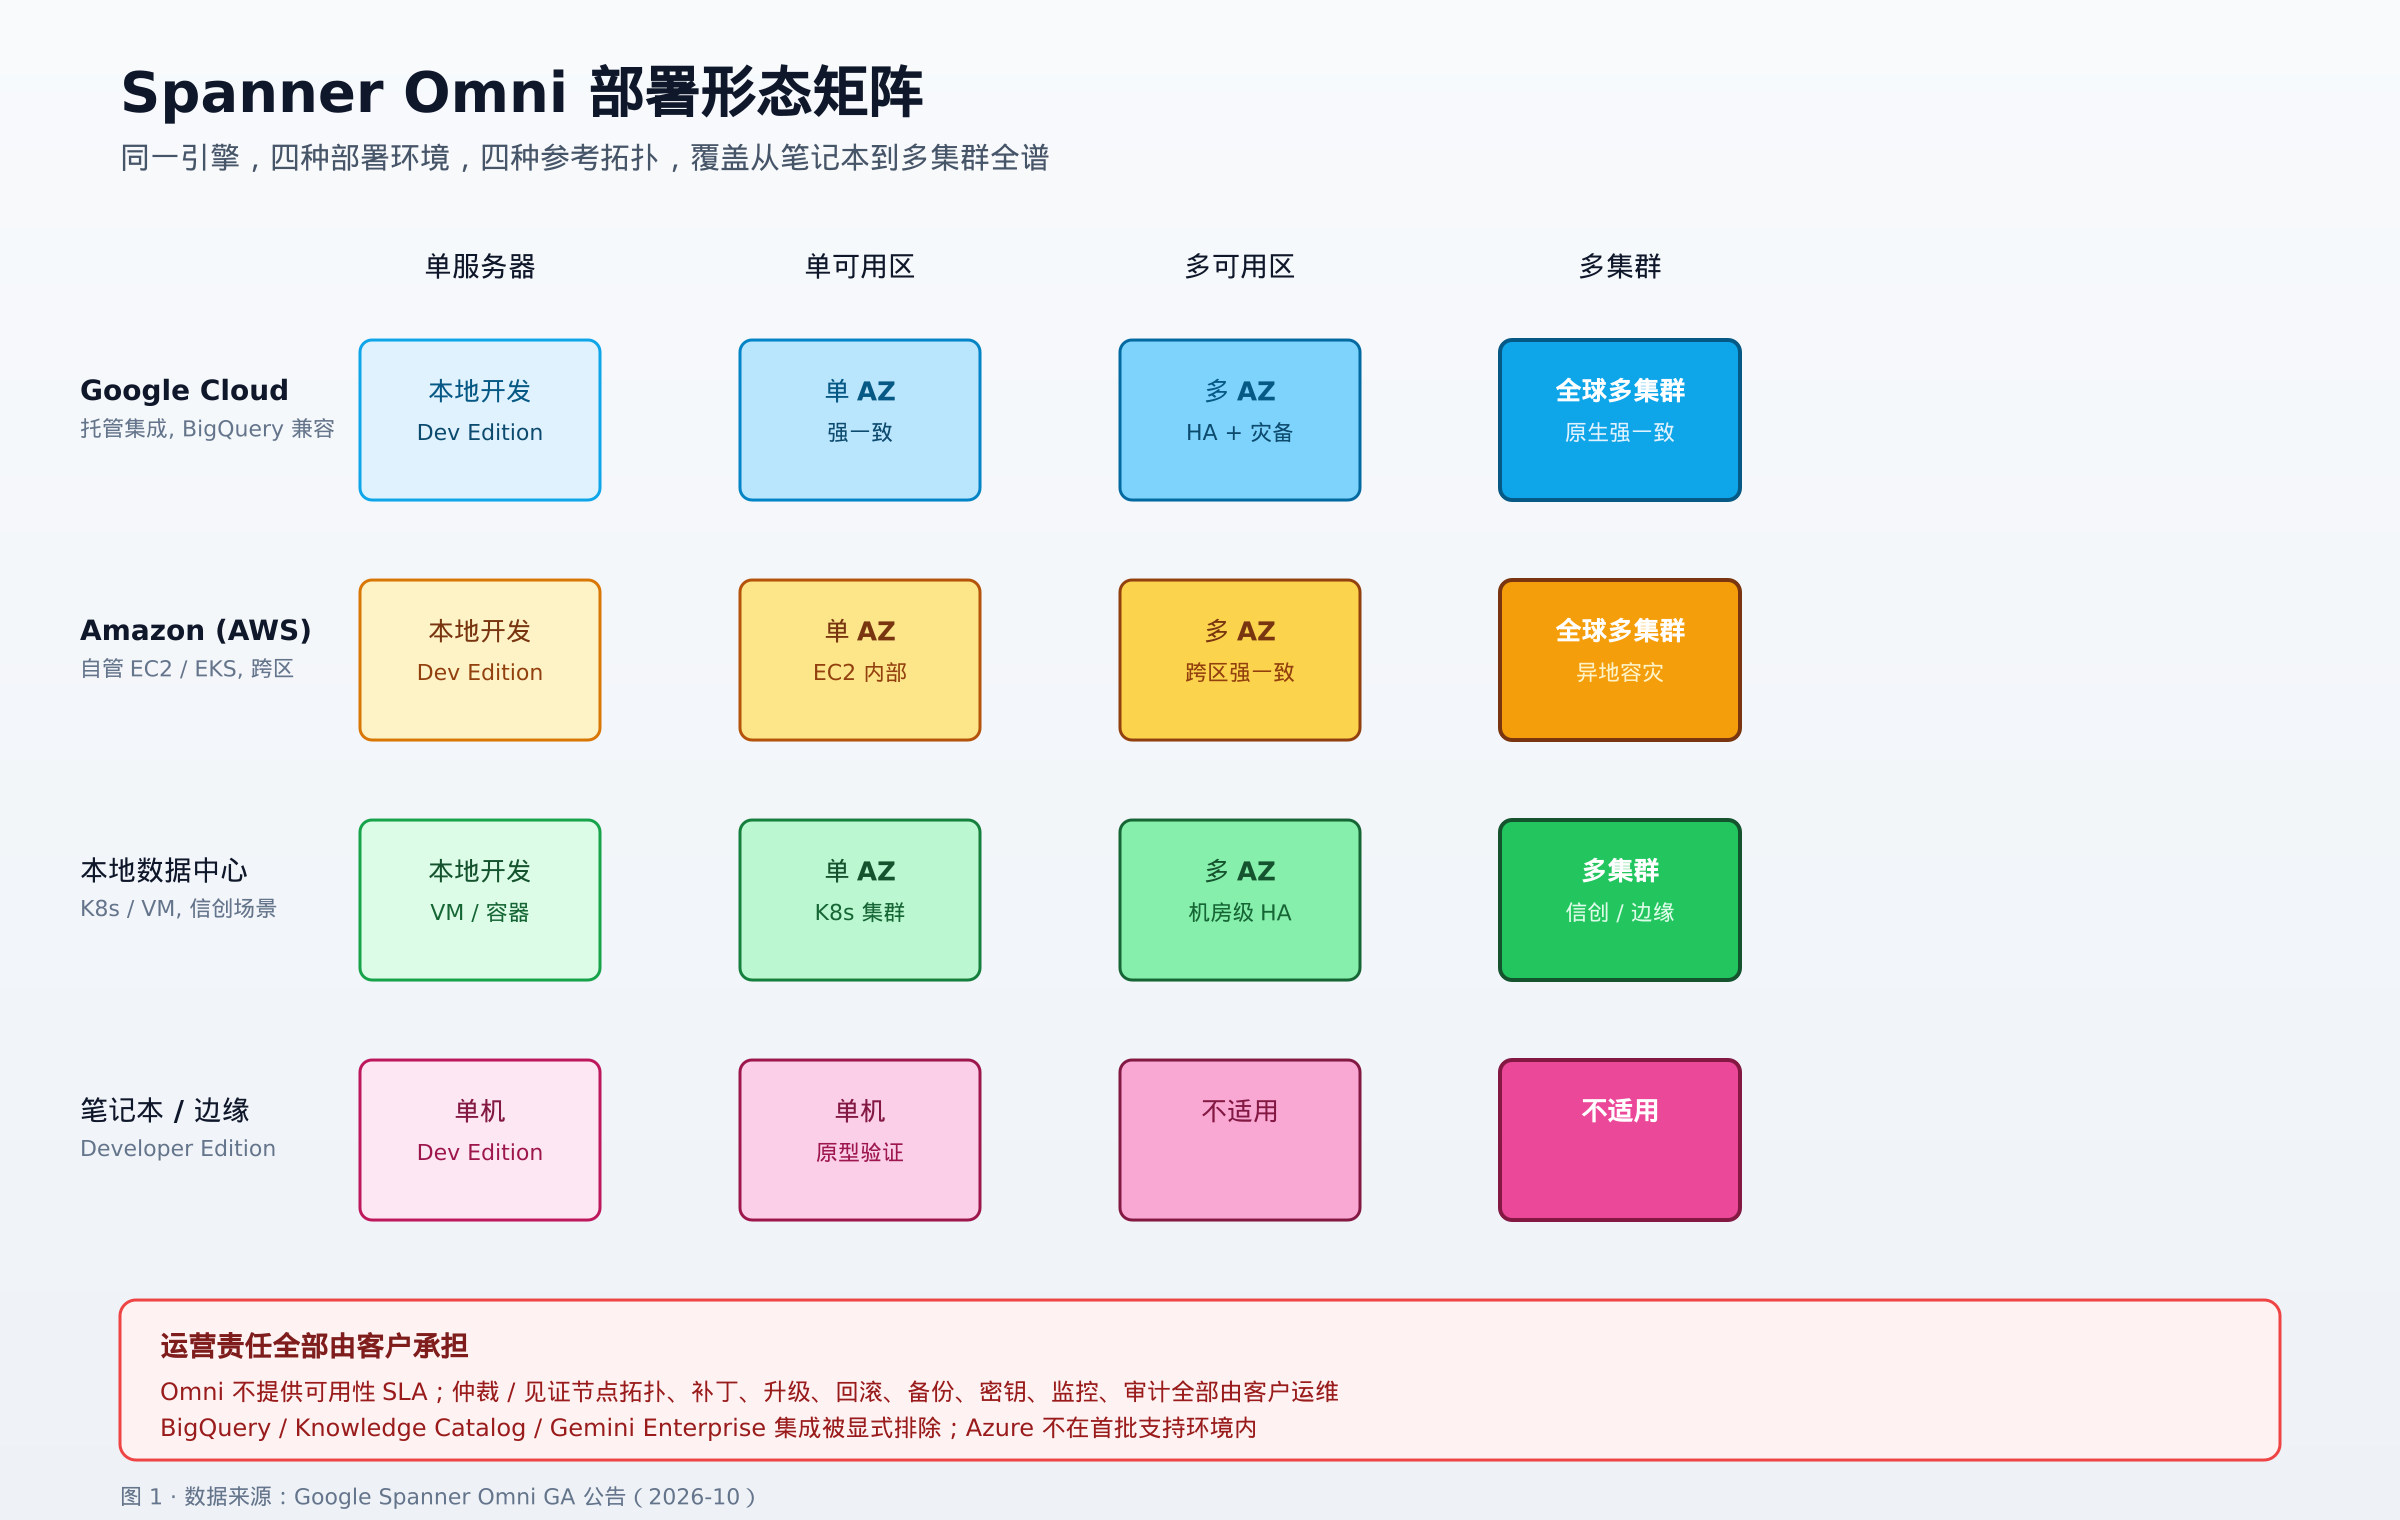
矩阵按"环境 × 参考拓扑"展开,四个参考拓扑分别是单服务器、单 AZ、多 AZ、多集群。深色单元代表 GA 推荐配置;浅色单元代表可用但有限制;空白单元格代表当前不适用(笔记本跑到多集群在工程上不现实,实际被官方划掉)。
注意矩阵右下角的红色提示:Omni 不提供可用性 SLA,客户必须自己负责仲裁 / 见证节点拓扑、补丁、升级、回滚、备份、密钥、监控、审计。这是 Omni 与托管 Spanner 最大的商业差异,不是技术差异。
三、两条关键替换路径
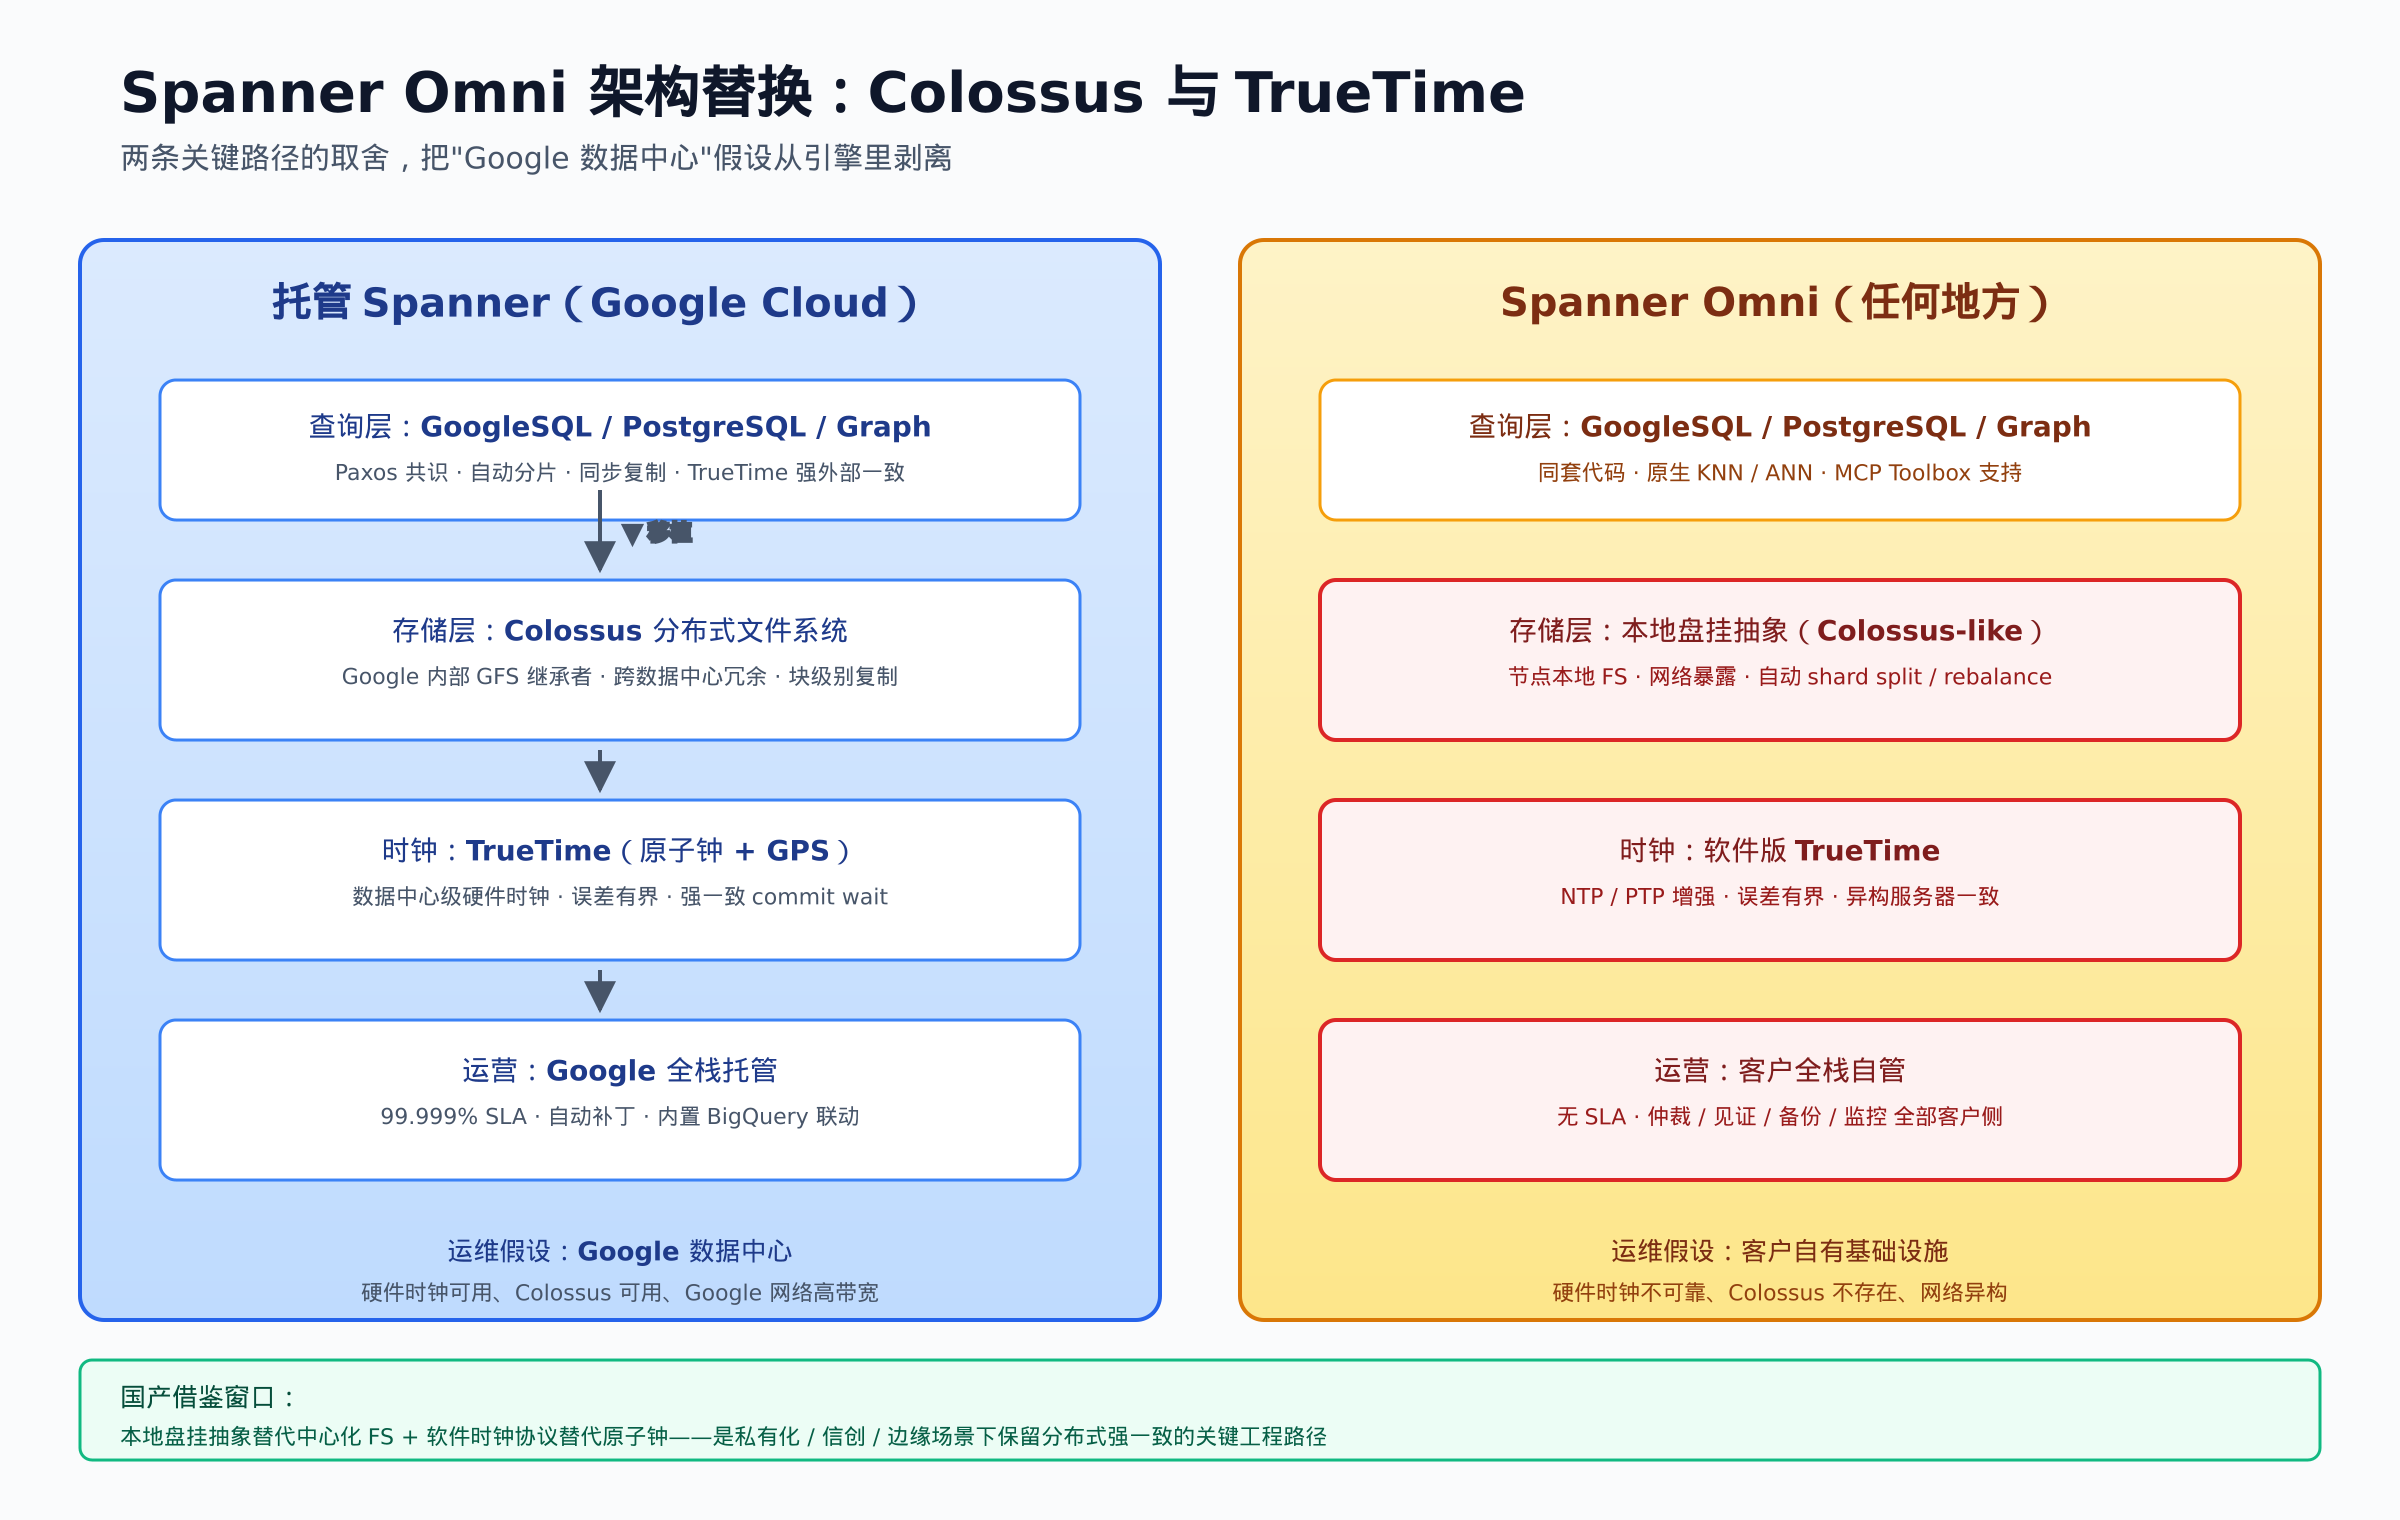
3.1 存储:Colossus → 本地盘挂抽象
托管 Spanner 的存储层是 Colossus,Google 内部 GFS 的继承者,数据中心级冗余、跨机架复制、块级别多副本。客户环境里没有 Colossus,所以 Omni 用了一套"本地盘挂抽象":
- 每个节点把写入落到自己的本地文件系统(NVMe / SSD)
- 通过网络把这块"本地"暴露给其他节点,模仿 Colossus 的块设备接口
- 由软件自动做 shard split 与 rebalance,在所有可用服务器间分配负载
Google 内部说法是"足够 stand-in 的替代品,能匹配托管 Spanner 在大多数工作负载上的表现",但显式标注"不是 Colossus 本身"。这意味着:在 Omni 上,客户要为存储层的可靠性负责(节点盘坏了就是坏了,没有跨数据中心冗余自动补上);同时 Omni 默认会建议多副本部署来抵消这一层风险。
3.2 时钟:TrueTime → 软件版本
TrueTime 是 Spanner 强外部一致性的物理基础,Google 数据中心每个机架都接了原子钟和 GPS 接收器,通过 API 给出"当前时间"和"误差上界",Spanner 在 commit 时主动 wait 这个误差窗口。客户机房不可能为每个节点装原子钟,所以 Omni 用了一套软件时钟方案:
- 基于 NTP / PTP 增强的时钟协议,在异构服务器之间给出误差有界的时间戳
- 把传统 TrueTime 的 commit wait 重叠到无关数据库操作上,维持外部一致性
- 不再要求硬件时钟,代价是延迟上界略高(误差窗口比原子钟大)
这条替换对实际工作负载的影响比存储那条更隐蔽:在跨地域场景下,Omni 的 commit latency 可能比托管 Spanner 高 10–30%,但仍然提供同样的"读自己写"与全局单调读语义。
四、多模型 + 向量 + Graph 混用
Omni 完整保留了 Spanner 多模型能力,并首次原生支持向量:
- 查询接口:GoogleSQL、PostgreSQL、Spanner Graph Language 三套并存
- 向量:原生支持 KNN / ANN 索引,允许把语义相似性查询与结构化 SQL 过滤在同一语句里组合
- 图:Spanner Graph 可与向量检索在同一查询里混用,适合"先向量召回再图遍历"的混合检索场景
- 全文与列存引擎:作为 GA 一部分提供,与关系 / 图 / 向量数据共存
这一组合的工程意义是:Omni 不再是单纯的 OLTP 分布式 SQL,而是把"向量 + 图 + 关系"整合成单一多模型引擎。这是 Snowflake / Databricks / ClickHouse 之外,又一家把"通用数据底座"作为对外定位的头部厂商。
五、MCP 与"操作记忆层"
Omni 在 GA 同时声明支持 MCP Toolbox(MCP 是 Anthropic 推动的 AI agent 工具调用协议)。具体能力是:
- agent 可以读取 Spanner Omni 的库表结构(schema inspection)
- agent 可以执行有限范围的 DML 与查询,作为"操作记忆层"
- 同一份 Omni 实例可以跨多云部署,agent 在任意云侧都能拿到一致的视图
这条能力对应的市场判断是:下一代数据库的差异化不只是 TPS / QPS,而是"对 AI agent 的友好度"。Supabase 在 70% 新库由 Agent 创建的背景下同时收购 Turso,Spanner Omni 在这里把 MCP Toolbox 作为一等公民,说明这件事已经不是单家厂商的动作。
六、付出的代价:被显式排除的集成
Omni 不是"白嫖" Spanner 的所有能力,以下集成在 Omni 上不提供:
- BigQuery 联动:无法从 BigQuery 直接查询 Omni 表(反向可以,Omni 数据可导出到 BigQuery)
- Knowledge Catalog:元数据治理集成缺失
- Gemini Enterprise:无法在 Omni 上跑 Google 自家的生成式 AI 工作流
- Azure 部署:首批支持环境不含 Azure(只有 Google Cloud / AWS / 本地 / 笔记本)
另一项商业代价是 SLA:Omni 没有可用性 SLA,客户必须自己承担运维责任。对很多企业来说,这一条比技术差异更影响采购决策。
七、给技术人的结论
- 分布式 SQL 的"可下载"边界第一次被打到企业能用的程度:Omni 不是 CockroachDB 那种"用 PostgreSQL 协议重新写一套分布式",而是真把 Google 自家的 Spanner 引擎搬到客户机房,这给国产分布式数据库(尤其是 OceanBase / TiDB / PolarDB-X)一个新的对照基准。
- 本地盘挂抽象替代中心化 FS 的工程路径,值得国产团队研究:在私有化 / 信创 / 边缘场景下,中心化分布式文件系统(类 GFS / Colossus)很难落地。本地盘挂抽象 + 自动 rebalance 是被 Google 验证过的可行路径,工程团队可以参考其接口设计。
- 软件时钟替代原子钟是另一条隐藏的工程宝藏:国产团队在做"全球分布式强一致"时,通常默认需要原子钟或 GPS,Omni 证明"软件时钟 + commit wait 重叠"也能维持外部一致性,这条对没有原子钟采购能力的厂商尤为重要。
- MCP Toolbox 是一等公民:如果你的数据库还没有 MCP 接入计划,2026 年 Q4 之前应该补上。
八、谁该认真看 Omni
- 金融 / 政企客户:数据不能出云,但需要 Google 级强一致——Omni 是首次有这种组合的工业级产品
- 多云架构师:已经决定"主要在 AWS"但希望"关键数据可用 Google 引擎"的客户
- 边缘 + 集中混合场景:边缘用 Developer Edition,集中用商用版,引擎一致
- 国产分布式数据库研发团队:两条替换路径(本地盘挂抽象、软件时钟)是 2026 年最值得对照的工程实现
九、不该现在就选 Omni 的场景
- 单云 + 不想自管运维的客户——直接用托管 Spanner
- 需要 BigQuery / Knowledge Catalog / Gemini Enterprise 联动的工作流——必须留在 Google Cloud
- 已经在 Azure 大量投入的客户——首批不支持
- 强需求 99.999% SLA 的场景——Omni 没有