



2026-10-13 一周内,Vectorize 把 Hindsight 推到 1.0 GA + Memlake 企业存储引擎上线,Tencent 开源 TencentDB Agent Memory——两个不同步的产品在同一周落在 Agent 长期记忆这条赛道上。两家做法不同:Vectorize 走对象存储 + 自家检索引擎,Tencent 走本地 SQLite + 语义金字塔。但它们给出的硬指标——1 亿条记忆 99 分位召回 < 80 毫秒、写入每秒 1.2k–1.5k 条、Hindsight GitHub 49k+ star——把"Agent 长期记忆"这件事从"向量库里塞点 embedding"推到了一个新的产品类目。
一、为什么"Agent 记忆"不是向量库、不是文档库、不是时序库,但又都在用它们
要理解 Agent 记忆作为一个独立品类,先要理解它不像什么。
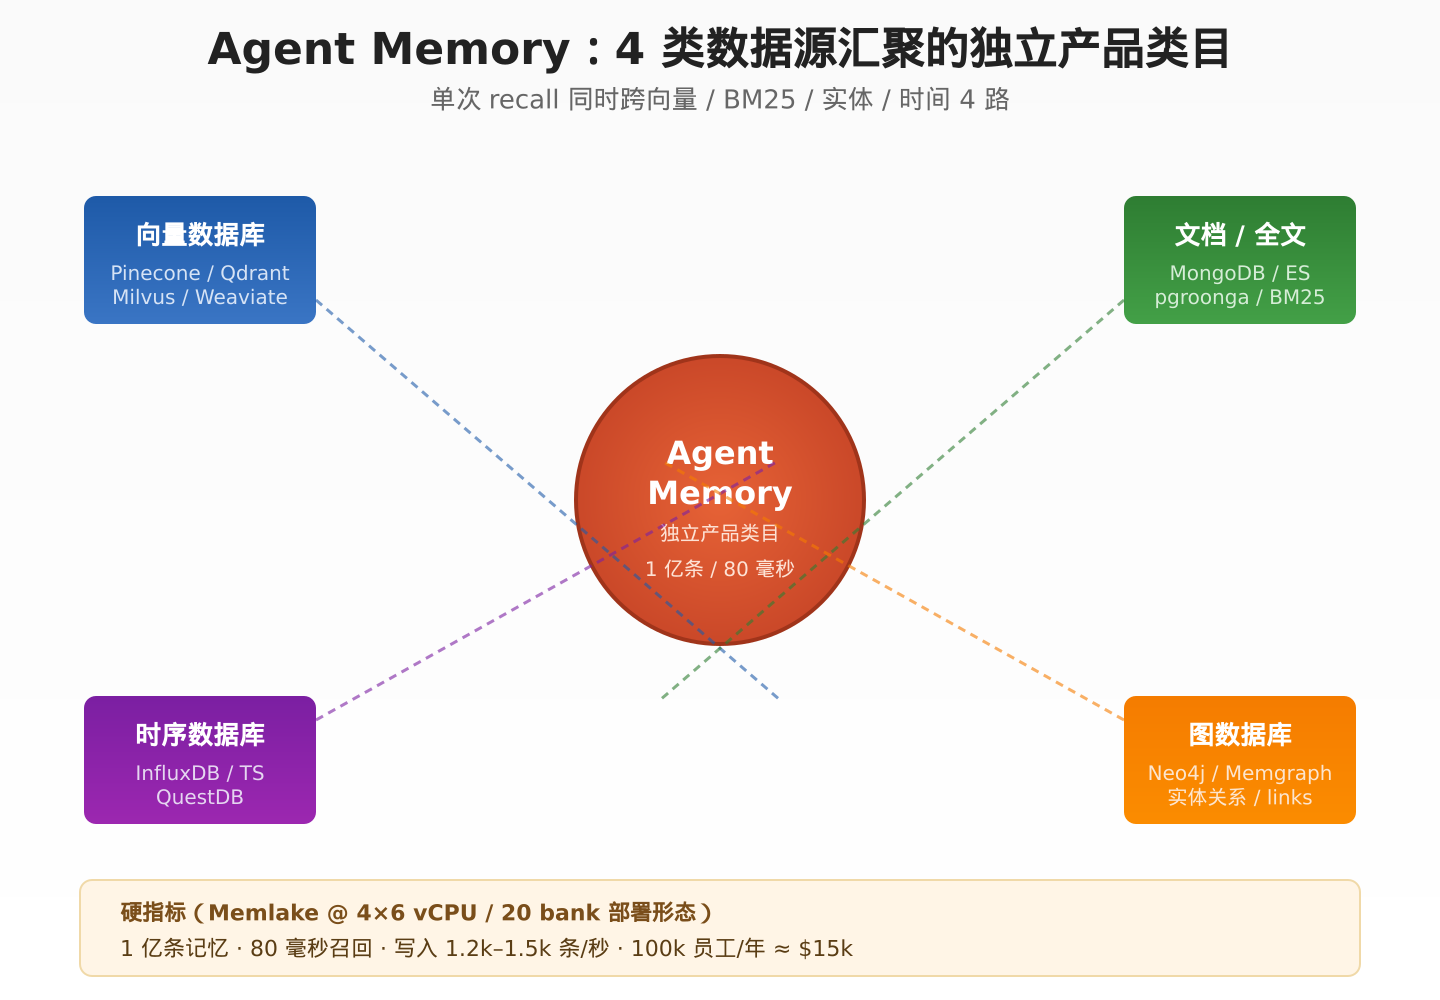
不像向量库,是因为 Agent 长期记忆不是"找最相似的 5 条 embedding"。一个 agent 一次 recall 通常要同时拿到 4 个维度的结果:用关键词匹配的"上次提到 X",用语义相似的"类似 Y 的情况",用图关系找到"和 Z 关联的 N 个事件",用时间窗找到"过去 30 天的 M 条记录"。任何一个维度缺,agent 都会重复犯错或漏掉上下文。纯向量库在过滤召回时往往要把多次 query 串起来;Hindsight Memlake 在一个请求里跑完这 4 路。
不像文档库,是因为 Agent 长期记忆不是"存一堆 PDF 让我查"。每条"记忆"是一条结构化的事件对象——发生时间、来源、关联实体、tags、embedding 字段。文档库假设"查询"和"文档"是两个集合,中间靠 RAG 接;记忆库假设"事件流"和"实体"和"时间"在同一索引里。
不像时序库,是因为记忆的访问模式不是"过去 24h 的指标"。Agent 关心"这件事跟 6 个月前那次对话的相似度"和"这个用户最近 30 天 5 次交互的轨迹",不是设备遥测。
像它们的,是因为每条记忆仍然需要 embedding、BM25、entity 链接、时间戳。Memlake 把这 4 路放在同一个对象存储桶里,跑 TLA+ 验证的协调协议;TencentDB Agent Memory 走 SQLite 单库 + 语义金字塔简化。两种实现都承认"4 路并行 + 跨域检索"是记忆库的核心。
二、Vectorize Hindsight 1.0 + Memlake 的工程取舍
Vectorize 在 10-13 同时做了两件事:开源 Hindsight 1.0(继续跑在 Postgres 上),以及把企业级存储引擎 Memlake 接入 Hindsight Cloud(大部分租户已经切到 Memlake,老组织可一键迁移保持 memory ID 不变)。这个双轨设计本身就是个产品判断:1 亿条记忆以下的中小规模,Postgres 仍然够用,运维简单;超过 1 亿条或对成本敏感的大规模,Memlake 接管。
Memlake 的核心工程取舍是把"记忆数据"和"运营数据"分到不同的存储后端。
记忆数据走对象存储——每条记忆是不可变日志条目,桶由租户自管(S3、GCS、认证过的 S3 兼容存储)。每个 bank(逻辑容器)是一个前缀,下面挂 log、segments(向量聚簇、BM25、entity、time、links)、manifest、head pointer。协调靠 bucket 的条件写,不靠单独的 DB、锁服务或 leader——这是 TLA+ 验证过的协议,每次写都做并发检查。
运营数据继续走 Postgres——banks、settings、后台任务队列、审计日志、账户元数据。Memlake 不接管这部分,Postgres 仍然负责一致性要求更高的运营状态。
stateless 服务层——gRPC 后端,内存 + 本地 NVMe 缓存。逻辑上无状态,所以横扩不涉及重新分片;bucket 是单一事实源,缓存是只读。
这套架构给出的硬指标(4×6 vCPU 跨 20 个 bank,1→200 recalls/s):
| 维度 | Memlake | Postgres 同集群 |
|---|---|---|
| p50 (ms) | 40–43 | — |
| p99 (ms) | 73–80 | 513 – 5300 |
| 写入 (memories/s) | 1,200–1,500 | 55–80 |
| 单 bank 99 分位 (300 万条记忆) | p50 71 毫秒 / 99 分位 90 毫秒 | — |
| 100k 员工一年总成本 (模型) | $15.1k | $58.4k |
写入对比 15–27×、成本 1.5–2.2×、99 分位稳定 < 100 毫秒——是 Memlake 给出的工程级承诺。BEIR SciFact 检索质量(不加 cross-encoder)跟专业向量库相差 0.3%,加上 graph 搜索 NFCorpus 升到 0.3645;这意味着"在记忆库里同时做向量和 BM25 检索"已经不输专用引擎。
三、Tencent 的另一条路:本地 SQLite + 语义金字塔
10-13 同时开源的 TencentDB Agent Memory 选了截然不同的工程形态:单 SQLite 库 + 语义金字塔(semantic pyramid),不依赖 Pinecone 这类托管云向量库。GitHub: TencentCloud/TencentDB-Agent-Memory。
定位明确写出来:“100% 本地环境运行,不依赖外部云向量数据库”。对于 Agent 部署在隔离网络或本地数据中心的场景,这条路线不绕开云依赖、不把 embedding 推到第三方——记忆在自家文件系统里。
这个选择背后是承认一个现实:很多 agent 团队的"长期记忆"需求不是百万条规模,而是几千到几十万条。SQLite + embedding + 简单金字塔足够承载;当规模真到百万级时,再迁移到 Hindsight Memlake 这种分布式实现。**这种"先用 SQLite 把产品跑通,规模到了再换引擎"**的策略,对早期 Agent 创业团队尤其友好。
Tencent 和 Vectorize 在产品哲学上是反过来的:
- Vectorize 假设客户终将到 1 亿条规模,所以一上来就按对象存储 + TLA+ 验证的协调协议做
- Tencent 假设客户早期在 10k–100k 规模,所以一上来就 SQLite + 简单金字塔,让客户零基础设施起步
两条路同时存在,反而证明"Agent 记忆"是一个真实的产品类目——需求足够多样化,单一形态吃不下。
四、为什么 1 亿条记忆 + 80 毫秒响应是入门门槛
把"1 亿条记忆 + 99 分位 < 100 毫秒"作为 2027 年入门门槛,是基于三个具体场景:
企业级 agent 部署。 一个 1000 员工的 SaaS 公司,每个员工每天 30 条 agent 交互(query、建议、决策、回顾),一年下来 1000 × 30 × 250 ≈ 7.5M 条/年。乘以 3 年使用周期、合并交叉上下文、加上团队 agent 的多用户关系,3 年内很容易到 5000 万–1 亿条。在这个规模下,99 分位 > 500 毫秒意味着 agent 在用户等待时会卡顿;99 分位 < 100 毫秒才让 agent 跟得上对话节奏。
autonomous agent 长时间运行。 一个做代码 review 的 autonomous agent,跑一周会累积 100k–500k 记忆(每个文件修改、每个测试结果、每个用户反馈)。规模本身不大,但 query 模式是高并发的细粒度 recall(每次工具调用前都要 look up 上下文),对单次延迟极敏感。Vectorize 的场景对比:100 个自主 agent 一个月的记忆量约 4.9 亿条,Postgres 在这个规模下 99 分位 5.2 秒;Memlake 99 分位仍 < 0.35 秒。
多租户 SaaS。 一个 RAG-as-a-Service 的多租户平台,每个租户都有自己的 agent 群。Memlake 的 20 bank 设计天然支持按租户分片;Postgres 走 schema 隔离也行,但 recall 路径上要绕 schema 路由,99 分位难做低。
Hindsight 的 GitHub 增长曲线(2025-12 开源,4 月 10k star,8 月 20k,9 月 40k,本周 49k+)和 1M+ Python 下载(不到 6 个月)说明这是真实需求在兑现,不只是技术爱好者的玩具。
五、跨厂商信号:4 类厂商在同一方向加注
本周不只是 Hindsight + Tencent 两条线。新增的相关动作(按时间序):
- 2026-10-13 Hindsight 1.0 + Memlake GA——Vectorize 把对象存储 + TLA+ 验证协议压成产品
- 2026-10-13 TencentDB Agent Memory 开源——本地 SQLite 路线
- 2026-10-12 Hindsight 跨 4 路检索(向量+BM25+entity+time)单请求完成——产品功能侧的一致信号
- Snowflake Semantic Studio GA(10-12)——虽不是专门的 Agent Memory 产品,但 Snowflake 的"语义视图"层在向"给 AI 看的企业语义"靠拢,是相邻赛道的同向动作
之前 OpenAI 把 Assistants API 的 memory 字段做出来、Anthropic 在 Claude 里加 projects 持久化上下文、MongoDB 把 Atlas Vector Search + Time Series 合并到同一个产品里——都是承认"Agent 长期记忆"是一个值得专门做的产品类目。但这些厂都还停留在"向量 + 时序的拼装"层面,没有把 4 路检索、TLA+ 验证的协调协议、企业级对象存储接成同一个产品。Vectorize + Tencent 的这一周落地,第一次把这个完整闭环做出可用形态。
六、国产数据库在 Agent Memory 上的两条路径
国产数据库在 Agent 长期记忆这条赛道上目前有两条现成路径:
对内嵌 PG / MySQL 的产品:可以直接借鉴 Hindsight 1.0(开源、Postgres-backed)的产品形态——把 4 路检索(向量 + BM25 + 实体 + 时间)做成 PG 扩展,租户级 bank 通过 schema 隔离。这条路对 OpenTenBase、PolarDB、TiDB(已经有向量索引)都适用,门槛在"4 路检索的统一协议"和"对象存储的协调一致性"。
对湖仓或 HTAP 平台:可以直接借鉴 Memlake 的对象存储 + TLA+ 协调思路,把记忆数据从运营数据中解耦放到对象存储,让 PG 端只承担"租户元数据 + 审计"。这条路对 Doris、StarRocks、SelectDB 等已经有对象存储的湖仓基础设施最自然。
但要避开一个工程陷阱:把"agent 记忆"做成"向量索引 + 一个文档表"的简单拼装。Hindsight 1.0 在 Postgres 上跑 OK,是因为它把 4 路检索(vector / BM25 / entity / time)的 planner 写在应用层,PG 端只做存储。把它硬塞进一个向量索引的扩展里,会丢掉 entity 链接和时间窗这两路,效果会远不如 Hindsight。
七、动手前要锚定的 3 个工程判断
如果你今天在评估"我们要不要自己做一个 Agent Memory 产品",或者"我们要不要选 Hindsight / Memlake / Tencent Agent Memory / 自建"的决策路径,几个可用的工程判断:
规模锚点:单租户 < 10 万条记忆——SQLite + Hindsight 1.0 模式够用;10 万–1000 万条——Postgres + Hindsight 1.0 模式;1000 万+——Memlake 类对象存储 + TLA+ 协调;1 亿条+——Memlake + 跨 bank 分片 + stateless 服务层。
工程优先级:单请求 4 路检索 > 单路极致延迟 > 跨 region 复制。Hindsight 的工程取舍明显把"4 路统一"放在第一位,单次 99 分位 80 毫秒 在工程上不算极限低,但够用。
开源 vs 自建:如果团队没有分布式系统经验、不要重新发明 TLA+ 协调协议,直接用 Hindsight 开源版(Postgres)或 Memlake 企业版;如果团队本身就是 PG / MySQL 内核开发,Hindsight 1.0 的代码可以 fork 集成到自家产品里。
避免的坑:不要把"agent 记忆"和"向量数据库"混为一谈,也不要把它做成"文档库 + 一个时间戳字段"。4 路检索是这类产品的核心差异化能力,少一路都会在具体场景下暴露问题。
参考链接:
- Vectorize Hindsight 1.0 + Memlake:https://hindsight.vectorize.io/blog/2026/10/13/memlake
- TencentDB Agent Memory 开源:https://github.com/TencentCloud/TencentDB-Agent-Memory
- Hindsight 1.0 仓库:https://github.com/vectorize-io/hindsight
- 2026 TSDB 选型对比(含 Agent Memory 跨分类讨论):http://www.pwwt.cn/news/4701417/
